基础模型与技术
AI DAILY BRIEF · EVENT NOTES · 2026.11.12
for AI era builders
EDITORIAL BRIEF
AI 行业简报 2026-11-12
今天筛出 18 个事件:大厂动态 13 条,技术进展 5 条,行业观点 0 条;另读 Hugging Face Papers 5 篇。
本期先发布已核实内容,仍有33条重要线索未完成核实,暂未收录;核实后将继续补充。
TOP 3 · 今日重点
先读重要变化,再看技术细节行业 / 商业动态
据《华尔街日报》报道,英伟达董事会准备罢免CEO黄仁勋,盘后股价跌超9%。
阅读解读与来源 →Agent 技术
Salesforce 发布 SFR-AutoR&D 研发智能体,称已用于改进生产嵌入模型 SFR-Embedding V3。
阅读解读与来源 →按主题查阅 18 个事件
行业 / 商业动态3
Agent 技术4
- AWS 发布 Amazon Bedrock AgentCore Web Search API,开发者可单次调用直接检索网页并获带摘录结果。
- Salesforce 发布 SFR-AutoR&D 研发智能体,称已用于改进生产嵌入模型 SFR-Embedding V3。
- Anthropic 的 Fable 5.2 在 Remote Labor Index 以 41.3% 完成率领先,Opus 5.5 与 GPT 6 Astra 分别为 21.25% 和 20.83%。
- Databricks 发布企业数据 Agent 基准,自报 Genie 通过率 91%、token 用量不到两个前沿 Agent 的一半。
工程实践2
政策、安全与社会影响4
A
大厂动态
AI 公司动态 · 模型发布 · 新业务 · 融资投资 · 人员变动
Google 向公众开放 Gemini 4 Carbon,并预览 Antigravity /swarm 多智能体功能。
事实摘要
据 The Verge 报道,Google 正在向公众推出 Gemini 4 Carbon,此前两周曾向部分“网络安全防御者”发布。
Simon Willison 在 2026 年 11 月 10 日的发布说明中写道,Gemini 4 Carbon 已向其他所有人开放。
Google 称 Carbon 是其“最强模型”,并有能力与 Anthropic、OpenAI 的顶尖系统竞争。
该模型通过 Gemini API、AI Studio 等渠道向付费开发者和企业客户开放,发布价为每百万输入 token 2 美元、每百万输出 token 10 美元,并计划于 12 月 1 日上调至 4/20 美元。
Google 还在 Google Antigravity 中预览 /swarm 功能,将单个提示词转为一个可实时追踪的协调智能体团队。
编辑解读
这次发布把能力更强的模型推给开发者,但与其只看 Google 自报的基准领先,不如关注 /swarm 引入的并行智能体协作是否真正降低复杂任务的端到端成本。 实际选择时还应把单 token 定价与更高的推理 token 消耗分开估算。
预计阅读 2 分钟
据《华尔街日报》报道,英伟达董事会准备罢免CEO黄仁勋,盘后股价跌超9%。
事实摘要
CNBC援引《华尔街日报》报道称,英伟达董事会正在准备罢免CEO黄仁勋,并可能最早于周三开会决定其去留。 《纽约时报》称黄仁勋与公司医疗业务副总裁Kimberly Powell存在婚外情;
此前黄仁勋已承认与一名被美国情报部门认为是中国间谍的女性有染,董事会并聘请Wachtell律所展开独立调查。 英伟达股价在消息公布后的盘后交易中下跌超过9%,本周此前已累计下跌7%。
编辑解读
这起报道是在黄仁勋已承认与涉嫌中国间谍的女性有染、并引发美国国会关注之后出现的,可能进一步放大NVIDIA的治理与市场压力。
预计阅读 55 秒
据 WSJ 报道,英伟达董事会准备罢免 CEO 黄仁勋,盘后股价跌超 8%。
事实摘要
据 Semafor 报道,英伟达董事会正准备罢免 CEO 兼创始人黄仁勋,时间可能就在当日,且董事会已向白宫通报这一计划。 报道称,此事发生在媒体披露黄仁勋有第二段婚外情之后;
董事会此前已启动由 Wachtell Lipton 主导的调查,核查他是否可能泄露公司机密或危及美国国家安全。 消息传出后,这家被报道市值约 4 万亿美元的公司股价在盘后交易中下跌超过 8%,触及 52 周低点。
报道还提到,英伟达在为超大规模云厂商供应先进芯片之外,也已签署数十亿美元规模的融资协议,为 AI 基建提供承销。
编辑解读
若决议真的落地,冲击不止于股价:英伟达既是先进芯片供应商,也是 AI 基建融资的承销方,CEO 更替会让云厂商对采购与在建项目的对手方风险重新定价。
但“准备罢免”尚未变成董事会正式决定,涉及个人私生活的指控也仅见于媒体转述,现阶段应把它当作待确认的重大治理风险,而非既成事实。
预计阅读 2 分钟
特朗普称 FBI 正调查英伟达 CEO 黄仁勋相关行为,股东集体诉讼已在美提交。
事实摘要
据 CNBC 报道,特朗普在白宫记者会上称,黄仁勋否认相关间谍指控,并表示“我知道 FBI 正在调查此事”。
同一报道称,洛杉矶一家律师事务所已在加州圣何塞联邦法院代表股东对英伟达和黄仁勋提起集体诉讼,指控其作出虚假或误导性陈述、给公司带来重大风险。 报道还提到,律师 Stephen Neal 被任命为董事会首席独立董事,英伟达缺乏继任规划令投资者担忧;
公司股价盘前上涨约 1%,此前一交易日下跌逾 4%。
编辑解读
对英伟达而言,CEO 个人法律与治理风险正在成为领导层连续性议题;盘前股价小幅反弹,尚不足以说明市场已排除“换帅”情景。
预计阅读 65 秒
Google发布Gemini Decisions API与Gemini Decision 1,单次前向打分最多1000个判定问题、输入每百万token 0.10美元
事实摘要
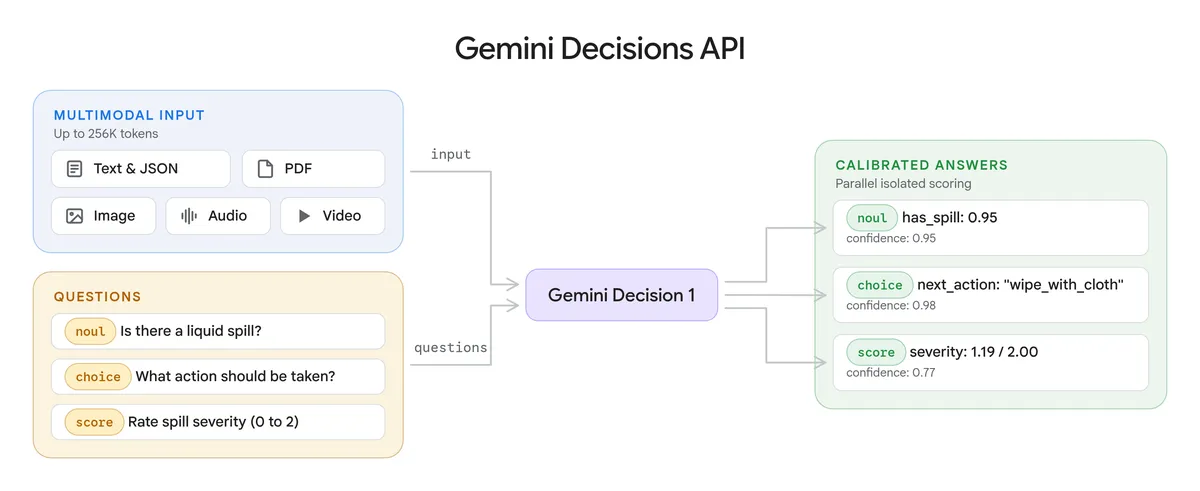
Google在2026年11月11日的官方博客中宣布推出Gemini Decisions API,该API由新模型Gemini Decision 1(gemini-decision-1)驱动,可通过Gemini API在Google AI Studio使用。
单次请求可传入最多256K token的多模态输入,并一次评估最多1000个是/否、多选和评分标准问题,模型以单次前向对候选选项打分并返回0到1的置信分数,而非逐token生成文字。
官方称端到端延迟150-250毫秒、模型计算中位50-100毫秒,在上下文不超过16K token时每请求1到100个问题延迟基本持平;
定价为每百万输入token 0.10美元、输出token不计费,并称在共享基准套件上比Gemini 3.5 Flash-Lite搭配Interactions API便宜近5倍。
Google还称该模型在Agent路由、推理、排序与多模态理解基准上领先且校准误差最低,Gemini Notebook已用它做实时模型路由,官方称日常查询延迟最多降低40%。
编辑解读
把“判定”从生成式解码里拆成打分端点,让Agent路由、工具选择与策略校验不必自建分类器或解析输出结构;Google称内部团队正是通过定义选项而非训练分类器上线这类功能。
延迟与价格条件写得明确,但“领先”“最低校准误差”均为厂商自述,选型前应在自有流量分布上复测置信分数。
预计阅读 2 分钟
AMD 宣布第六代 EPYC SP7 服务器 CPU 全面上市,Zen 6 架构平台开始由 OEM 出货、Azure 与 OCI 云实例将陆续可用。
事实摘要
AMD 宣布第六代 EPYC SP7 服务器处理器全面上市,基于 Zen 6 架构,覆盖 Agentic AI、企业、云、HPC 与通用计算;采用该处理器的系统已由领先服务器厂商出货,Azure 与 OCI 云实例也将很快可用。
AMD 称 EPYC 9996 是“全球最佳通用处理器”,对比 Nvidia Vera CPU 系统最高 3.7 倍性能,对比 Intel Xeon 6980P 系统最高 2.2 倍性能与 2.0 倍每美元性能;
其高频主机节点处理器最高 5.3 GHz,LLM 输出吞吐可达上代 EPYC 的 1.8 倍。
编辑解读
本条按 AMD 官方公告记录为第六代 EPYC SP7 全面上市,重点在服务器 CPU 与 Agentic AI 基础设施。
预计阅读 70 秒
安全公司 Claroc 称 Grok Build 分享链接可枚举数千在线应用并泄露内部资料,SpaceXSI 在媒体询问后移除相关链接。
事实摘要
据 Ars Technica 2026 年 11 月 10 日报道,安全公司 Claroc 称 Grok Build 的分享链接虽做了随机化,但平台的一项设计让任何人可以枚举数千个在线项目,点击链接即可打开应用并读取其中数据。
Claroc 称暴露内容包含内部商业计划、广告提案、体检结果、某明星邮轮的补给清单以及员工姓名和工号,其中 24 个由 SpaceXSI 自建的应用还暴露了标记为机密的入职计划与覆盖 594 个账户的销售区域地图。
Claroc 于周日通报 SpaceXSI,未获回应后一名员工在 X 上点名马斯克与 Grok 负责人 Matt Palmer;
SpaceXSI 在 Ars 发邮件询问后数小时内开始移除链接,报道发布时这 24 个应用链接均返回“app not found”。
编辑解读
这类带分享链接的 vibe-coding Agent 默认把用户应用放到公网,访问边界取决于平台配置而非用户选择,企业接入前需要评估链接枚举和数据分级风险。
报道显示 Claroc 取证时多数数据仍可访问,链接移除发生在媒体询问之后,受影响范围与修复方案仍待 SpaceXSI 说明。
预计阅读 2 分钟
英国警队监察机构报告称,回顾性人脸识别误配若被当作证据,可能致无辜者尤其少数族裔被错误逮捕。
事实摘要
英国警队监察机构发布的报告发现,若警员将回顾性人脸识别(RFR)的潜在匹配视为证据而非情报,可能错误识别或逮捕无辜者,少数族裔风险更高。
报告称,部分调查人员在依据潜在匹配采取行动前未进行足够佐证核查,少数情况下过度依赖RFR结果,导致不当调查行动。 报告还指出算法存在偏见,用户会上传模糊或多张人脸的劣质探针图像,且本应删除的拘留照片被保留,立法也未能跟上技术变化。
National Police Chiefs’ Council表示将继续以合乎伦理、相称且负责的方式使用RFR;Big Brother Watch和学者则批评把概率分数当证据、缺乏有意义的人工审查。
编辑解读
英国警察监察机构的报告发现,部分调查人员把回顾性面部识别结果当作证据而非需进一步核实的情报,这可能带来错误识别和错误逮捕风险,报告还指出算法存在偏向少数族裔等偏差。 基于这些发现,编辑判断是:采购与部署方应把人工复核、使用记录和数据保留约束纳入考量;
监察机构同时表示,更清晰的法定框架和更强的国家标准对维持公众信心至关重要。
预计阅读 2 分钟
Helsing 发布 AI 目标推荐平台 Clarity:由数百个 agent 汇总传感器数据,向武器系统移交目标须人工授权并署名。
事实摘要
据 The Decoder 2026 年 11 月 11 日报道,德国防务公司 Helsing 在柏林展示了名为 Clarity 的“agentic intelligence platform”,可处理传感器数据、开源情报、书面报告以及军方已在用的系统数据。
Helsing 称数百个专用 AI agent 并行工作,识别部队、设施与阵地,为人工审核准备目标信息,之后再打包给相应武器系统。
公司强调主权与人工监督:Clarity 运行在客户自有基础设施上,模型与界面在欧洲开发,数据与操作由军方单独控制,并遵循 MOSA、实现北约标准、可接入任意厂商的效应器。
Helsing 称打击决定仍由人选目标和授权每一次向武器系统的移交,只有在独立来源一致且能以高置信度判断时才推荐目标,每个决定都记录责任人的姓名。
文章指出这类系统的现实风险:据《华尔街日报》报道,美军在伊朗战事中以 Palantir 的 Maven 配合 Anthropic 的 Claude 提出并排序数百个目标,首个 24 小时打击约 1000 个目标,数日内超过 3000 个,军方内部出现“计算机让我这么做”的心态。
据 +972 Magazine 与 Local Call 的调查,以色列的 Lavender 系统曾在一段时间内标记最多 3.7 万名巴勒斯坦人为潜在目标,人工复核平均只有约 20 秒。
据 CNN 报道,2026 年春季美军一度准备登临一艘中国船只,原因是聊天机器人在情报报告中误称其载有核武器计划部件,直到行动前不久才被发现。
Helsing 未说明 Clarity 是否已在任何客户处运行,而 Palantir 的 Maven 已嵌入五角大楼与北约流程,并被多年实战打磨。
编辑解读
这类系统的瓶颈更多在人机交接的时间尺度:当人工复核被压缩到约 20 秒,署名授权更容易变成责任转移而非实质把关;做高风险 Agent 的团队应把可审计证据链和误报抑制放在吞吐量之前。
预计阅读 3 分钟
据 WSJ 与 The Information 报道,OpenAI 三季度营收环比增约 50% 至 100 亿美元,调整后经营亏损升至 109 亿美元。
事实摘要
据《华尔街日报》和 The Information 报道,OpenAI 第三季度营收环比增长约 50% 至 100 亿美元,上一季度环比增幅仅 17%–18%,一年前为 39 亿美元。
同期调整后经营亏损从 101 亿美元升至 109 亿美元,未计入的股票薪酬升至 26 亿美元。 同期,Anthropic 营收增长 47% 至 170 亿美元,包含股票薪酬的经营亏损为 5.67 亿美元,并计划启动 IPO。
OpenAI 总裁 Greg Brockman 称,企业业务在三季度翻倍并已占营收大头;ChatGPT 周活跃用户达 12 亿,付费订阅用户达 1 亿。
编辑解读
单季 100 亿美元营收与 109 亿美元调整后经营亏损同时出现,说明规模扩张尚未转化为盈利;报道把效率差距归因于商业模式——Anthropic 侧重企业与 Claude Code 等工具,OpenAI 仍承担广泛研究与高成本消费业务。
降价并把资源转向 Codex 之后,企业侧留存与毛利结构能否改善,比单季营收增速更值得跟踪。
预计阅读 2 分钟
AWS 发布 Amazon Bedrock AgentCore Web Search API,开发者可单次调用直接检索网页并获带摘录结果。
事实摘要
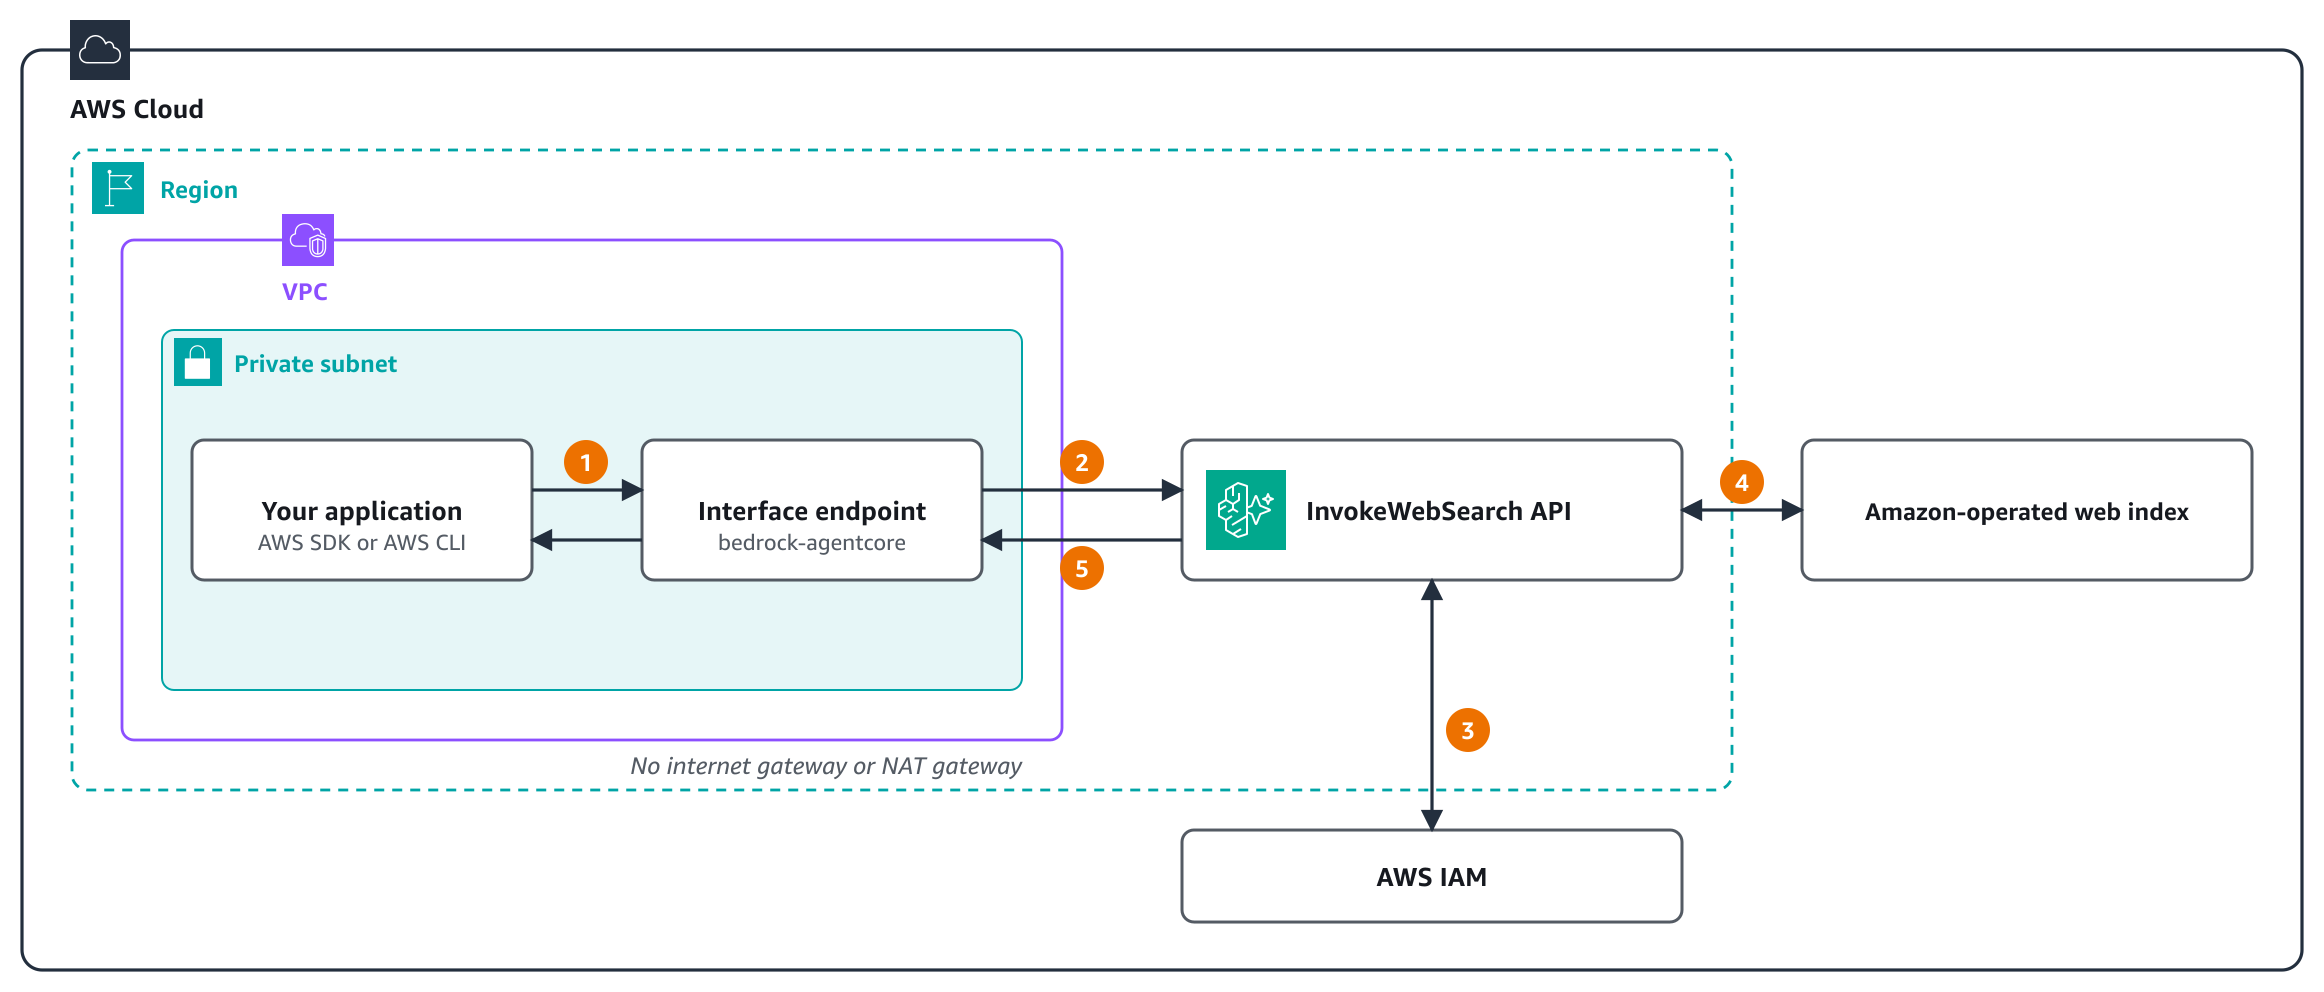
AWS 博文宣布在 Amazon Bedrock AgentCore 上推出 Web Search API,自有代码可用单次 API 调用搜索网页,无需先创建资源。
该 API 返回 Amazon 运营的网页索引排序结果,每条含文本摘录,并在可得时含标题、URL 和发布时间;支持域名与发布时间范围过滤,每次可请求 1–25 条,查询最长 200 字符。
请求使用 IAM 凭证经 SigV4 签名,无需 API key;查询在 AWS 内处理,不发送给第三方搜索引擎。 配套 LangGraph 示例并行研究三个包生态,AWS 自测为 36 秒,对比顺序执行 99 秒;
文章说明证据检查不核实严重性、利用状态、受影响版本或首次披露时间。
编辑解读
对自建 Agent 循环或使用 LangChain/LangGraph 的团队,它降低了网关接线和凭证管理成本;但结果可信度、重试缓存和面向用户的来源标注仍要由应用层承担。
预计阅读 2 分钟
Google DeepMind 发布 AlphaGenome 2,聚焦 DNA 变异对不同细胞的影响。
事实摘要
Google DeepMind 公布 AlphaGenome 2,称该模型用于研究 DNA 变化如何影响不同细胞,为疾病机理研究提供更细的细胞层面视角。
预计阅读 20 秒
据《卫报》报道,Palantir被曝游说英国前卫生大臣,推动其AI工具扩展至NHS全科医生记录。
事实摘要
据《卫报》报道,通过《信息自由法》获得的WhatsApp消息指向Palantir英国负责人Louis Mosley与英国前卫生大臣Zubir Ahmed的沟通,内容为游说将其AI软件扩展至NHS全科医生记录;Palantir未否认该高管身份。
这轮推动发生在2月,但GP数据此前被明确排除在Palantir与NHS England的3.3亿英镑联邦数据平台合同之外,政府也曾承诺GP数据不会进入国家平台。
Palantir称其Foundry软件用于GP数据可带来更快看诊、更有效管理虚弱患者和预防性护理,并称能保持数据本地控制;英国医学会则担忧“范围蔓延”会损害患者信任。 卫生部拒绝置评;
Palantir回应称,数据共享可改善NHS,但软件如何推广由政府决定。
编辑解读
这组通信把AI供应商参与公共医疗数据治理的游说透明度与合同边界具体化;后续观察点是英国卫生部是否推动合同变更或立法授权。
预计阅读 2 分钟
B
技术进展
Hugging Face · 技术报告 · 论文 · Benchmark · RL 研究
HF PAPERS
查看当天论文
Hugging Face Papers 速读
逐篇读取当天 paper 页面,由 deepseek-v4-1-flash-economy-261017 生成中文摘要。
用比特级 Ising 编辑修复语言模型
研究摘要
Tree-Ising 把权重修复建模为 BF16 权重上的稀疏离散优化,按输出行分解为 QUBO 并用 GPU 退火或模拟分叉求解。
权重编辑离散优化模型修复


Condition Shifting 实现少步流式视频生成(APEX)
研究摘要
APEX 用条件移位在生成器内估计生成分布的速度场,省去 DMD 的独立 fake-score 网络,保留冻结参考教师与 Self-Replay Forcing。
视频生成少步采样流式生成

WikiTrace:证据链接记忆减少 LLM Agent 的记忆诱发退化
研究摘要
WikiTrace 把每条经验教训链接到其来源轨迹及成败原因摘要,让 Agent 行动前可下钻核验、补全或纠正教训。
LLM Agent外部记忆基准评测

Salesforce 发布 SFR-AutoR&D 研发智能体,称已用于改进生产嵌入模型 SFR-Embedding V3。
事实摘要
Salesforce AI Research 发布 SFR-AutoR&D,一套在给定目标、代码库和算力预算下自主提出假设、实现方法并对基线做受控实验的研发智能体,只有被证据证明准确且安全的改进才会保留。
Salesforce 称该系统已用于训练和改进生产 AI 模型,并自主改进了 Data Cloud 检索所用的 SFR-Embedding V3,还以开源模型 EmbeddingGemma 2 为基础产出 SFR-Embedding v4。
Salesforce 自报称,在 10 个 MTEB 公开检索任务上 nDCG@10 提升 6.13 分,第二轮约 9 小时优化带来 36% 吞吐提升和 17% 延迟降低,质量几乎无损。
Salesforce 称这类研究循环原本常需数周,该系统约 80 小时完成一轮。
编辑解读
系统边界是研究人员设定目标、预算、评测和数据约束,无相对基线的可测量提升时模型维持原状。
预计阅读 2 分钟
Google DeepMind 发布 AlphaProof Code,报道称其四周完成 Signal 加密核心验证。
事实摘要
Google DeepMind 发布 AlphaProof Code,用数学证明软件代码符合安全规格;报道称其在 Signal 加密协议上完成通常需数年的验证,耗时四周。
与早期停在理论设计阶段的验证不同,该系统验证了运行在用户设备上的实际加密核心代码。
专家定义形式化安全需求后,基于 Gemini Carbon 的 AI agents 用 Lean 写了超过600万行证明代码,标记约1%代码库供人工审查,两个故意植入的测试 bug 被立即发现。
DeepMind 计划通过 CodeMender 等系统将该方法扩展到电网和医疗设备。
预计阅读 60 秒
Anthropic 的 Fable 5.2 在 Remote Labor Index 以 41.3% 完成率领先,Opus 5.5 与 GPT 6 Astra 分别为 21.25% 和 20.83%。
事实摘要
2026 年 11 月 10 日的报道显示,Anthropic 新模型 Fable 5.2 在 Scale Labs 与 CAIS 的 Remote Labor Index 上完成 41.3% 的真实自由职业项目。
该基准包含 240 个 Upwork 项目、总价值约 14.4 万美元,由人类专家在专业软件中按可付费交付标准核验。 同一榜单 Opus 5.5 和 GPT 6 Astra 为 21.25% 与 20.83%,一年前最高为 Manus 的 2.5%;
Scale Labs 称 Fable 5.2 在音频/音乐、建筑与室内设计、3D 建模提升最大,工业设计与动画仍弱。
编辑解读
RLI 的人工判定方式是打开交付文件并与自由职业者原稿比对;研究者尝试用 AI 自动评审,但称其会因无法操作专业软件而高估模型。
预计阅读 70 秒
Databricks 发布企业数据 Agent 基准,自报 Genie 通过率 91%、token 用量不到两个前沿 Agent 的一半。
事实摘要
Databricks 与 Turing 合作构建企业数据 Agent 基准,在实时 Databricks 工作区中比较 Genie 与两个前沿 Agent 的答案准确率、token 用量与完成耗时。
基准除表格外还纳入 notebook、仪表盘、保存的 SQL 查询和文档等分析资产,基于虚构的英国电力与燃气供应商 Calderwick Energy(数百张表,最大表约 1.2 亿行半小时级电表数据),每个 Agent 在每个任务上运行 5 次。
Databricks 自报的数据表显示,Genie 通过率 91.0%、每轮平均 token 431,829;Agent A 为 45.0%、889,019 token,Agent B 为 58.0%、1,051,070 token。
方法上 Genie 原生运行,另两个 Agent 经 Databricks toolbelt 接入,且该 toolbelt 排除了 Genie MCP。
Databricks 称在缺乏工作区知识积累的新部署中差距可能更小,并表示 Genie Ontology 现已正式可用。
编辑解读
这是 Databricks 发布的 Genie 对比评测:两个前沿 Agent 以 Agent A、Agent B 代称,Genie 原生运行而对手经 Databricks toolbelt 接入,因此通过率差异不宜直接当作模型能力排名。
预计阅读 2 分钟
LlamaIndex披露第三方AI Agent对LlamaParse的四天渗透测试,覆盖OWASP LLM十大风险。
事实摘要
LlamaIndex在官方博客中披露,其文档解析产品LlamaParse接受了第三方Trace的AI Agent渗透测试,采用获取凭证但不提供源码和云配置的灰盒方式,在生产环境与相互隔离的测试组织账户中进行。
测试覆盖OWASP LLM十大风险以及标准OWASP Web应用风险,历时四天;Trace的Agent会自行读文档、建GitHub仓库、写Python代码并生成样本PDF,以此跑通端到端流程。
LlamaIndex称发现的“问题”集中在业务逻辑、组织之间的边界,以及模型被文档内容引导时的行为,并称平台自身问题已全部修复或缓解;文中给出的案例是,一份在白色页面上加印白色文字的发票被抽取时返回了隐藏的总金额与另一个银行账号。
该公司主张抽取环节应如实报告页面上有什么,至于是否信任某个字段值,应由客户管线中的业务规则决定。
编辑解读
这条属于厂商自述、并由厂商付费委托第三方执行的安全测试,与以往该主题下多为论文和评测的信号不同,可作为文档类Agent安全工程的实践样本,但修复清单与攻击细节仅在NDA下提供摘要,无法独立复核效果。
预计阅读 2 分钟
C
行业观点
X 大 V · YouTube / Podcast · Builder 观察 · 开发者讨论
今天没有足够明确的入选事件,先空着。