AI DAILY BRIEF · EVENT NOTES · 2026.10.13 for AI era builders

EDITORIAL BRIEF

AI 行业简报 2026-10-13

今天筛出 17 个事件:大厂动态 8 条,技术进展 8 条,行业观点 1 条;另读 Hugging Face Papers 5 篇。

A

大厂动态

AI 公司动态 · 模型发布 · 新业务 · 融资投资 · 人员变动

01

广东省委书记调研腾讯总部,马化腾携首席 AI 科学家姚顺雨出席座谈

AI SummaryIT之家 10 月 12 日援引中国新闻网“三里河”报道,10 月 8 日广东省委书记黄坤明调研腾讯总部,马化腾带首席 AI 科学家姚顺雨并排座谈,被视为广东与腾讯押注 AI 的信号;报道称 2025 年广东 AI 核心产业规模突破 3000 亿元、约占全国四分之一。材料同时回顾:姚顺雨 28 岁,清华姚班、普林斯顿博士,2024 年加入 OpenAI 参与 Operator 与 Deep Research,提出 ReAct 范式;2025 年 12 月起主管腾讯 AI Infra 部与大语言模型部,2026 年 7 月起统一管理基础模型部;腾讯 9 月底上线个人智能体 LightVela,仍处开发者体验阶段。

解读这是一次政企 AI 信号展示而非技术事件:腾讯把从 OpenAI 回流的姚顺雨作为“AI 一号位”摆在省委书记面前,等于公开确认其人事与组织地位。但报道没有提供任何技术输出,腾讯 AI 叙事仍停留在架构调整与产品预告,可验证的成果要看混元新模型和 LightVela 的实际表现。

预计阅读 2 分钟
02
ModCraft 融资/收购/估值 36kr.com 网页来源 · 未核验

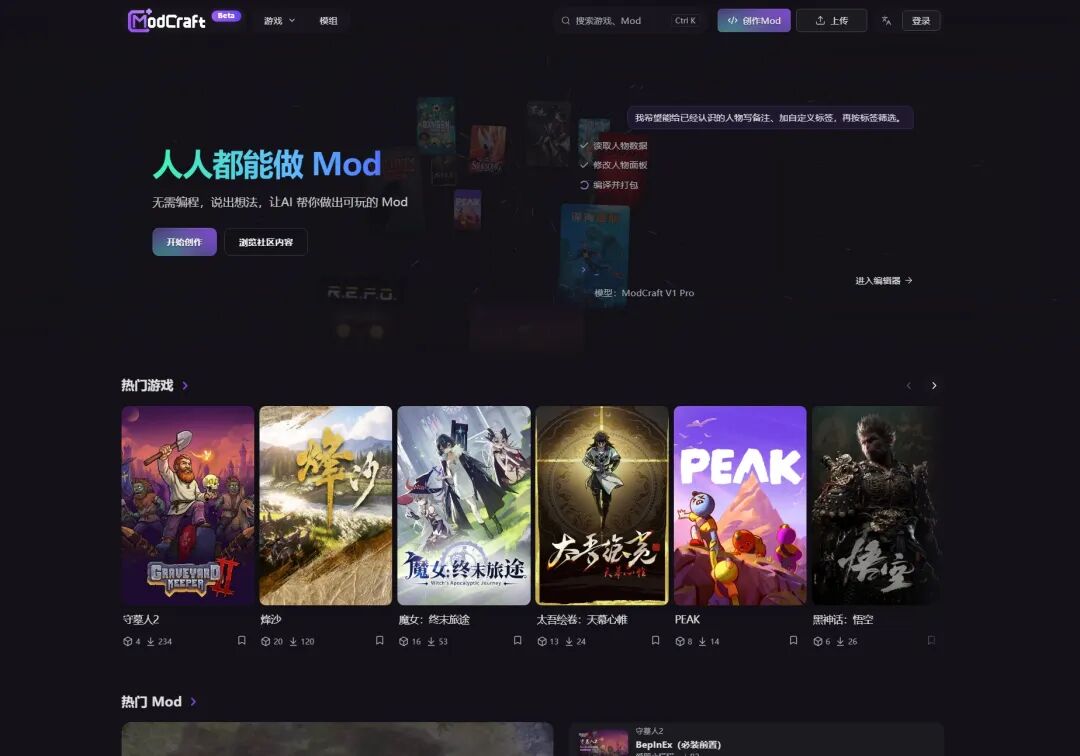
AI游戏Mod平台ModCraft获数千万人民币种子轮融资,用玩家Mod数据训练游戏AI

AI Summary36氪报道,AI游戏Mod创作平台ModCraft完成数千万人民币种子轮融资,投资方为商汤国香资本和L2F光源创业者基金,资金将用于AI模型训练与平台增长。平台目前支持以自然语言制作游戏Mod,并已上架28款Steam知名游戏(含《太吾绘卷》《光与影:33号远征队》)。公司长远计划基于玩家的Mod创作、反馈与运行数据训练面向游戏开发的AI模型,已与字节跳动等模型厂商合作提供训练数据。创始人李硕认为,Mod是AI进入游戏仿真环境的接口,短期商业化包括订阅和B端定制与数据服务。

解读本质不是一家 Mod 工具公司,而是把玩家 Mod 创作与试玩反馈打包成可交易的高质量训练数据;壁垒在于能否持续获得新游戏和创作者内容,而不只是工具效率。

预计阅读 75 秒
03
Microsoft 模型/产品发布 36kr.com 网页来源 · 未核验

微软发布基于阿里 Qwen3.5-9B 后训练的决策模型 Microsoft-Decision-1

AI Summary据36氪快讯,微软于10月12日推出基于阿里 Qwen 的决策模型 Microsoft-Decision-1。微软官方称,该模型由 Qwen3.5-9B 经后训练得到,在结构化决策任务中的时延和准确性超过通用 LLM 及 Jev 1.13.0 等热门决策模型,后续或推广至更多领域。原文未给出评测集与具体数值,相关性能声明目前无法独立验证。

解读微软用开源 Qwen 作为自家决策模型底座,说明头部云厂商开始直接在后训练层商业化外部基座模型。此类“基于某开源模型打造”的信息通常混合合作与竞争叙事,在缺少官方公告和基准细节前,应视为待验证的产品动态,而非既定技术突破。

预计阅读 55 秒
04
无问芯穹 融资/收购/估值 IT之家 中文转述 · 原始出处未核验

无问芯穹完成23亿元C轮融资,累计融资43亿元创AI Infra赛道纪录

AI Summary据证券时报消息,AI基础设施企业无问芯穹已完成23亿元C轮融资,成立以来累计融资达43亿元,单轮及累计融资额均创中国AI原生基础设施赛道最高纪录。该公司走“中间层”路线,不自研GPU和底层大模型,专注异构算力调度与软硬件协同,已实现华为昇腾等四种国产芯片与AMD、NVIDIA的混合训练,算力利用率最高达97.6%。另据彭博社引述知情人士,公司已保密递交港交所IPO申请,目标最快2027年上半年上市,该消息尚未获官方证实。

解读无问芯穹以“M×N”异构调度中间层路线获得资本高额押注,说明国产算力集群场景下“调度的钱”正在被重新定价;但融资纪录与IPO均属媒体口径,关键看43亿元能否转化为可复制的集群效率与商业收入。

预计阅读 70 秒
05
Pico(字节跳动旗下) 模型/产品发布 IT之家 中文转述 · 原始出处未核验

Pico Space Pro 头显实机外观照现身日本监管文件:外置计算模块设计,暂定 2026 年第四季度发布

AI Summary字节跳动旗下 Pico 的 MR 头显 Pico Space Pro 实机外观照现身日本监管机构认证文件(编号 202-JWM032,型号 B3110,与 FCC 认证一致),首次展示了实机外观和部分内部结构。实机采用外置计算模块设计,头带、面罩、额头支撑与 SDK 渲染图基本吻合;拆解图显示摄像头/传感器阵列、光学模组及中央散热风扇。此前信息显示其搭载 4000 PPI micro-OLED,采用双芯片架构:自研协处理器负责计算机视觉与图像处理,主处理器 CPU/GPU 性能为高通骁龙 XR2 Gen 2 的两倍。Pico 尚未官宣,暂定 2026 年第四季度发布。

解读监管文件曝光实机与内部结构,说明产品已进入认证阶段;但此前已从 9 月跳票至 Q4,且 FCC 保密期至 2027 年 2 月,节奏仍有变数。外置计算模块加双芯片指向端侧视觉与高算力,但这是硬件进展,与 LLM 主线关系有限。

预计阅读 2 分钟
06
阶跃星辰(StepFun) 模型/产品发布 IT之家 中文转述 · 原始出处未核验

阶跃 Step 5 Preview 上线腾讯 WorkBuddy,2026年10月12日至25日独家限免

AI Summary阶跃 StepFun 于 10 月 12 日宣布,旗舰模型 Step 5 Preview 上线腾讯 WorkBuddy,2026 年 10 月 12 日至 25 日在 WorkBuddy 独家限免。Step 5 Preview 于 9 月 20 日发布,面向 AI 编程、软件工程、专业知识工作与金融等场景,目标是提升真实世界 Agentic 任务表现,并计划于 10 月 15 日开源完整权重。模型采用稀疏 MoE 架构,总参数 600B、激活参数 27B,支持 100 万 Token 上下文,原生支持文本与视觉输入。

解读这是典型的渠道型商业动作:借腾讯 WorkBuddy 的企业工作台触达 B 端用户,“独家限免”是获客手段而非能力升级。模型技术信息全部来自 9 月 20 日发布时的存量内容,真正值得关注的节点是 10 月 15 日开源完整权重后的生态采用与付费转化。

预计阅读 70 秒
07
NVIDIA 模型/产品发布 NVIDIA 官方来源

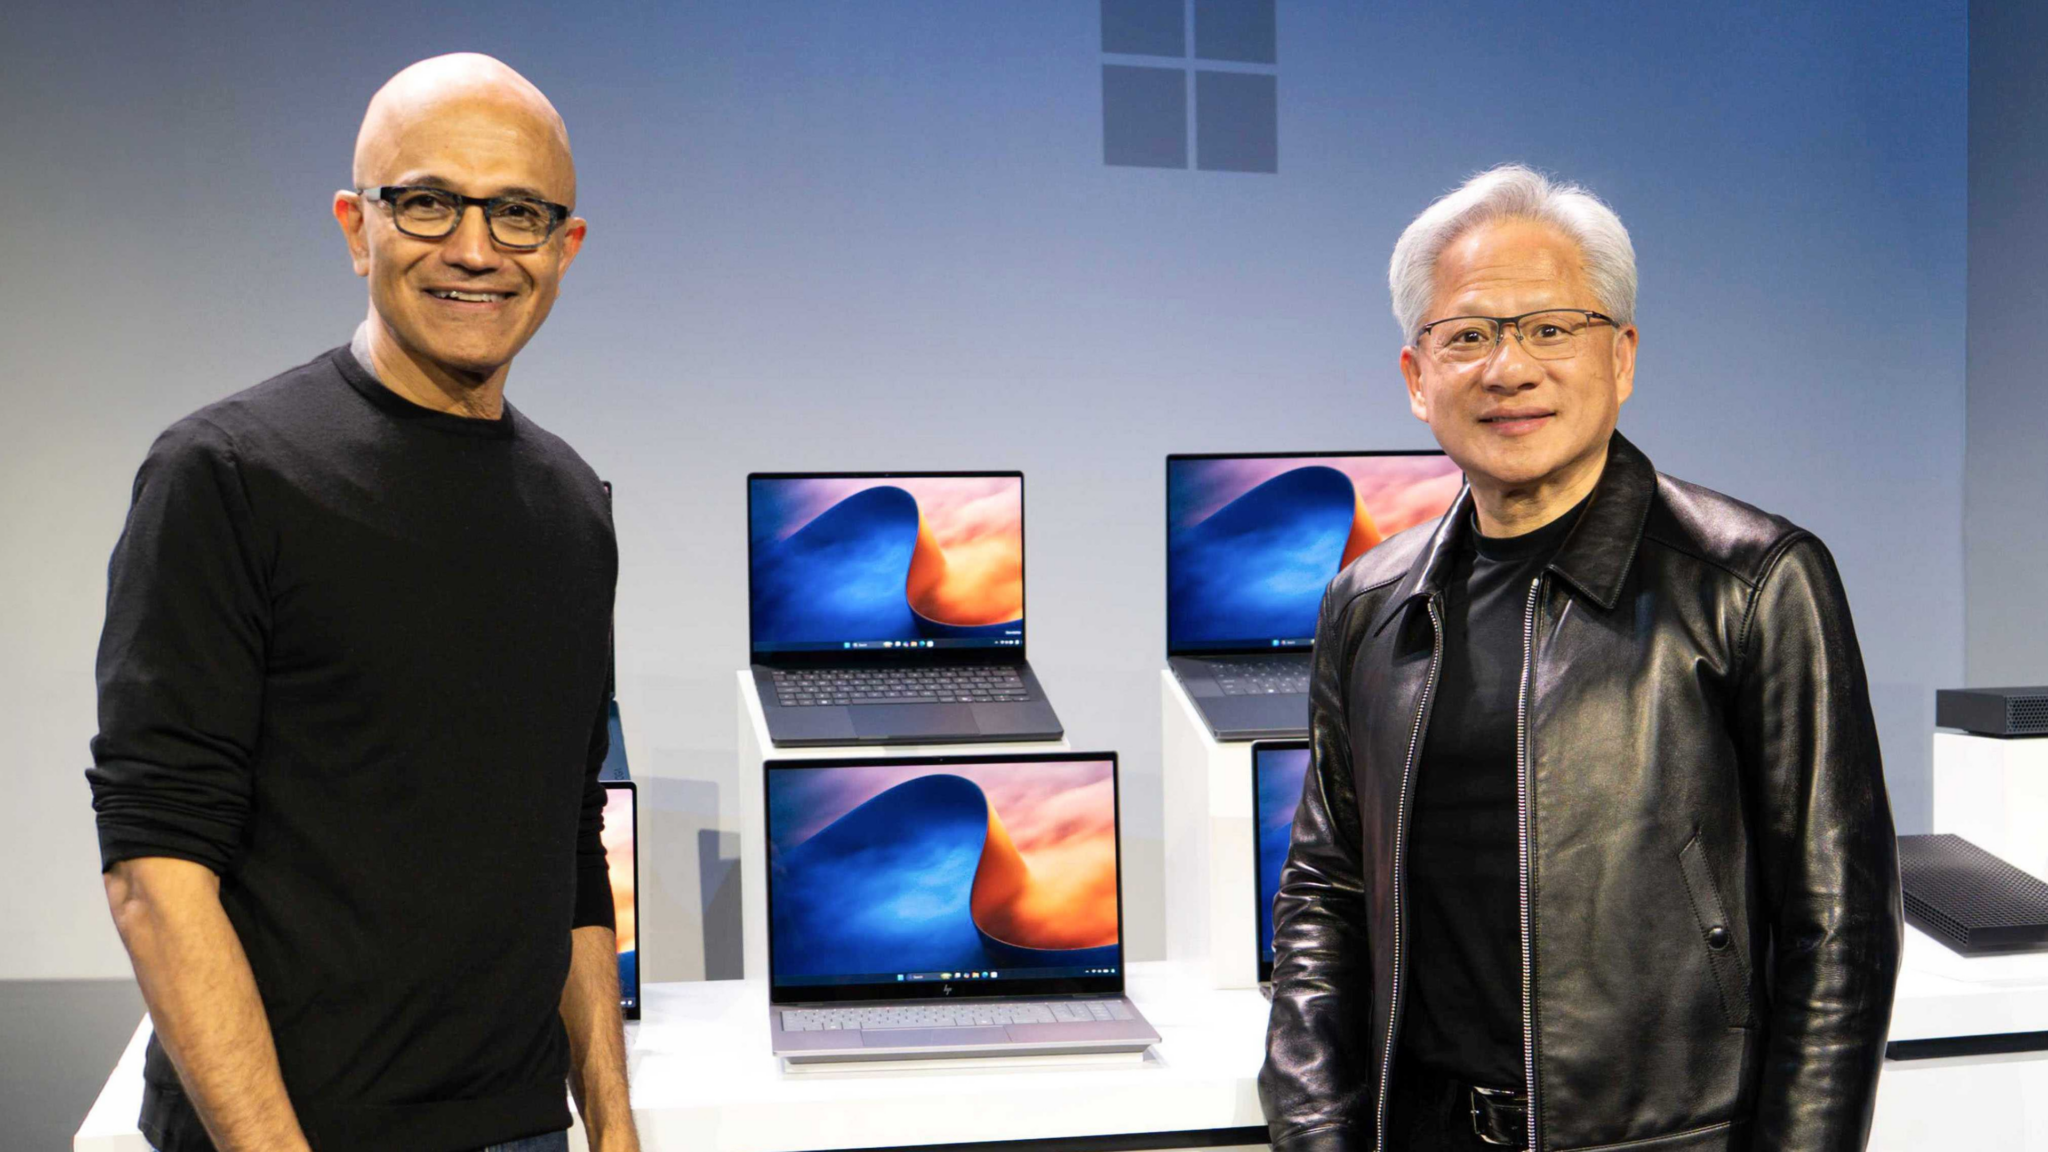
英伟达与微软联合发布 RTX Spark Windows PC 与 AI Agent 基础设施:预购开启、MXC 正式可用

AI Summary英伟达与微软在旧金山 Windows AI 活动上推出本地 AI 硬件与 Agent 基础设施更新:RTX Spark 笔记本预购 10 月 16 日开启,紧凑台式机 11 月开售。RTX Spark 集成 Blackwell RTX GPU(最多 6144 核)与 20 核 Grace CPU(600GB/s 互连),最高 1 petaflop FP4 算力和 128GB 统一内存,官方称可运行 Qwen 3.8 Flash Next(125B 参数)等模型;微软发布基于 RTX Spark 的 Surface Laptop Ultra,并宣布 Windows 执行容器(MXC)正式可用,使 Agent 在操作系统控制下安全后台运行。英伟达还预览了 DGX Station for Windows:采用 GB300 Grace Blackwell Ultra 桌面超算芯片,748GB 一致内存、20 petaFLOPS FP4 算力,面向本地运行万亿参数级模型。

解读英伟达正在把数据中心级推理栈复制到桌面端:RTX Spark 承接端侧 Agent 推理,DGX Station for Windows 则把 GB300 级算力搬到办公桌,配合微软 MXC 让 Windows 成为受管 Agent 运行平台。真正要验证的是“本地跑万亿参数模型”和“匹敌云模型”这类厂商宣称在真实工作负载下的表现。

预计阅读 2 分钟
08
Meta 模型/产品发布 Meta Newsroom 官方来源

Meta 发布 Muse Wonder 系列旗舰模型,Full 版仅限 Muse Code 订阅用户

AI SummaryMeta 在 10 月 12 日官方公告中发布 Muse Wonder 与 Muse Wonder Full。Muse Wonder 已通过 Meta Model API 和 Muse Code 提供,Full 版面向 Muse Code 订阅用户开放。官方介绍了跨对话保留相关信息的 Active Memory,以及遇到困难时尝试其他路径、恢复错误并持续完成任务的 Active Focus;Muse 应用将随后接入,先向订阅用户推出。前沿性能表述来自 Meta 自述,仍需结合具体任务与独立评测判断。

解读此次发布的可用性已有官方公告支持:基础版提供 API,Full 版采用订阅入口。性能优劣仍需独立评测,官方公告本身不等于第三方验证。

预计阅读 65 秒
B

技术进展

Hugging Face · 技术报告 · 论文 · Benchmark · RL 研究

HF PAPERS

Hugging Face Papers 速读

查看当天论文

逐篇读取当天 paper 页面,由 deepseek-v4-flash-ga-260731 生成中文摘要。

03

视觉驱动的人形机器人反应控制

AI Summary提出Reflex三阶段框架,通过RGB-D视觉实时预测物体运动并协调全身控制,使机器人能接住抛来的箱子。

人形机器人视觉反应控制强化学习
01
Arena(arena.ai) 研究/Benchmark IT之家 中文转述 · 原始出处未核验

Arena 第 41 周榜:Claude Opus 5.5 Max 首登智能体榜首,国产多模型稳居中上游

AI SummaryArena(arena.ai)发布 2026 年第 41 周(10.05-10.11)大模型榜:Anthropic Claude Opus 5.5 Max 首次入榜即登顶智能体榜,净提升度 15.53%、任务确认成功率 17.29%、工具幻觉率 0.37%;综合榜 gemini-4-argon-high 以 ELO 1525 蝉联第一,claude-opus-5.5-high(1507)升至第二;代码榜 claude-opus-5.5-high 升至第五(1550),与第二名 1551 统计并列。国产模型中 kimi-k3-max 综合榜第 16(1488)、qwen3.8-max 第 22(1483),整体稳定中上游。榜单基于匿名盲测投票反映用户偏好而非能力测试,误差范围内视为并列,新模型需积累票数才入榜。

解读这是用户盲测偏好而非能力测试:Claude Opus 5.5 Max 首秀登顶智能体榜值得跟踪,但置信区间 ±4.63% 且样本有限;国产模型稳定中上游,真正分水岭仍在头部两梯队。

预计阅读 75 秒
02
vLLM 研究/Benchmark vllm 官方来源

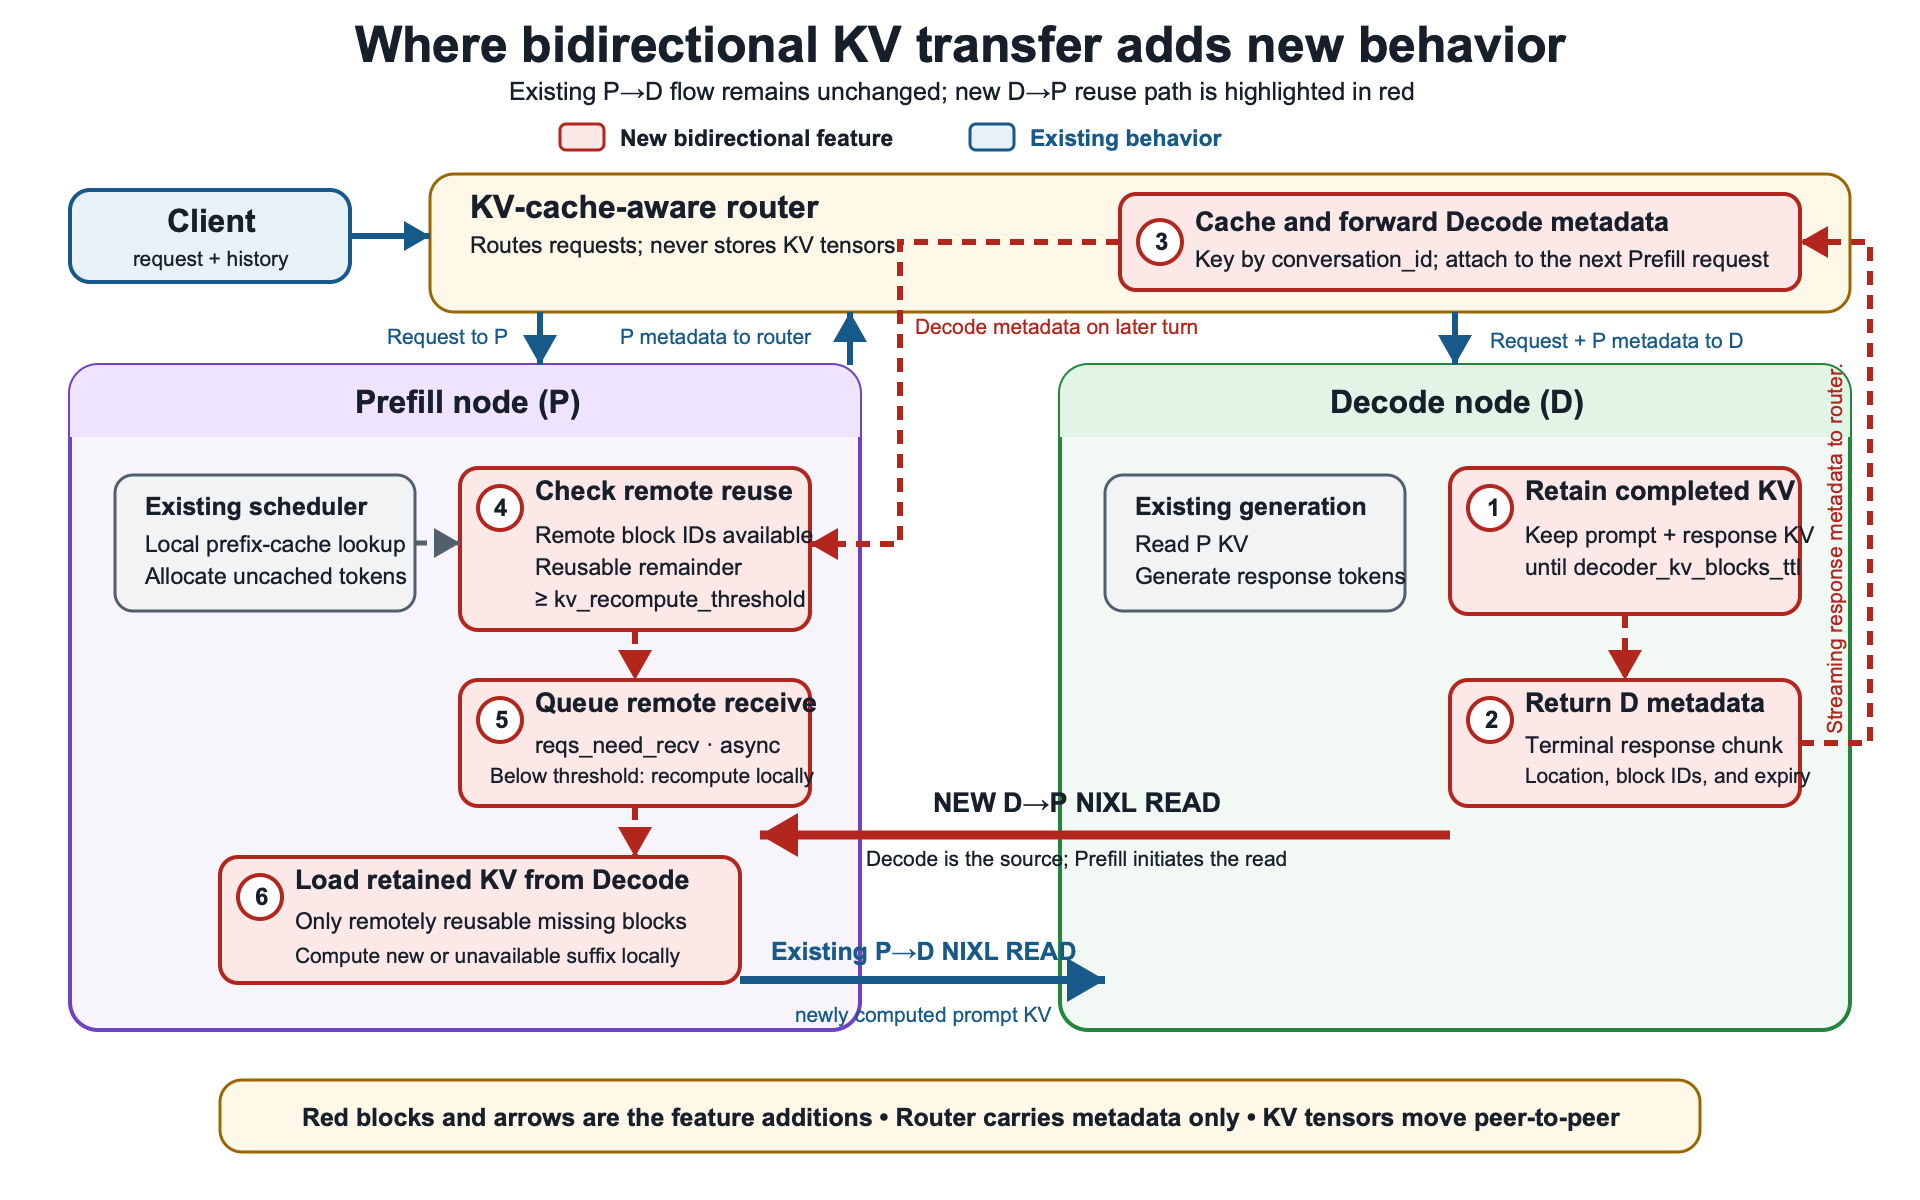
vLLM 博客:双向 KV 传输将 P-D 分离部署下多轮 Agent 工作负载 TTFT 最高降低 3.3 倍

AI SummaryvLLM 官方博客发布双向 KV 缓存传输:Prefill-Decode 分离部署中,decode 节点生成后按 TTL(默认 480 秒)保留 KV,经响应流把元数据交给 KV-cache-aware 路由器缓存;下一轮 prefill 节点本地前缀缓存未命中时,经扩展的 NIXL 连接器异步执行 D→P NIXL READ 复用 KV,默认 64 tokens 的 kv_recompute_threshold 决定重算或拉取。1P1D 部署(EC2 P5en + EFA,禁用 prefill prefix caching)实测:Qwen3-32B 在 24k 上下文 TTFT 从 778ms 降至 460ms(约 1.6x),GLM-5-FP8 在 20k 从 2334ms 降至 702ms(约 3.3x)。该功能最初在 AWS Trainium 上构建,已贡献给 vLLM 开源。

解读双向 KV 传输的本质是用低延迟网络读取替换多轮对话中反复的 prefill 重算,上下文越长、模型越大收益越明显。但这依赖 P-D 分离部署、配套路由器与 EFA 类低延迟网络,属于推理工程优化而非模型能力变化,实际采用需权衡 TTL 期间占用的显存。

预计阅读 2 分钟
03
Qwen Agent/开发者基础设施 IT之家 中文转述 · 原始出处未核验

阿里千问发布 QwenGyre:面向超长程智能体任务的在线强化学习框架

AI Summary阿里千问今日发布QwenGyre,面向超长程智能体任务的在线强化学习框架。它将GPU分成若干计算单元,任务批次完成后空出单元动态转入训练,仍在运行的任务保留进度与缓存;并以Token-in Token-out记录生成上下文、按共享前缀组织轨迹树,只展开被选中路径,超时部分完成的任务用Partial Scoring提供反馈。官方在NL2RepoBench在线RL实验中,以每次rollout约70万token训练48步,通过率从52.5%升至58.5%;相同GPU预算下相对Async实现1.78×端到端加速,训练分数与Async、Colocate接近。在Qwen3.6-122B的跨任务验证中,NL2RepoBench、DeepSWE、TerminalBench均获端到端提速。

解读QwenGyre的实质是把单次数小时的agent rollout切成弹性调度的计算单元,将中断轨迹和超时部分结果纳入训练,解决长程任务在线RL的样本利用率问题。1.78×加速来自GPU占用优化而非算法改进,通过率提升幅度和跨任务收益仍需独立验证。

预计阅读 2 分钟
04
安踏集团 Agent/开发者基础设施 leiphone.com 网页来源 · 未核验

安踏×火山引擎落地电商 Agent:海外订货决策缩至10-20分钟、TikTok退货月均自动建单超1000张

AI Summary雷峰网报道,安踏集团借助火山引擎模型与智能体能力,在电商业务落地三类 Agent。AI 带货视频 Agent 用 ArkClaw 采集并拆解对标视频、由 Seedance 2.0 生成商品短片,新人半天即可产出合格视频,同等 Token 消耗下每日多产出约15条;海外订货 Agent 将四套模板封装为 Skill,完整下单决策从半天缩至10—20分钟,手工录入减少约90%,数据准确率超99%,覆盖鞋服两条产品线;退货单据 Agent 在安踏 TikTok 跨境业务中每月自动创建超1000张退货单,计划复制到斐乐等品牌。文中数据均出自安踏员工口述,属于厂商案例报道。

解读这是企业 Agent 落地的典型样本:不追求模型表现,而是选择规则明确、跨系统、重复录入的流程打包成 Skill,收益直接体现为人力替换(订货决策半天→10-20分钟、月均自动建单超1000)。但数据全部来自安踏员工口述,未披露异常兜底和人工复核比例,跨品牌复制才是真正考验。

预计阅读 2 分钟
05

开源排行榜 whatmodel.sh 发布:输入 RAM/GPU 即可查本机能跑的模型,称 Qwen3.8 27B 本地得分与 GPT-5 相当

AI Summary开发者 jakemanger 发布开源项目 whatmodel.sh,一个面向本地可运行模型的 AI 排行榜:用户输入 RAM 和 GPU 配置,即可查看本机可运行的模型、统一得分、运行命令,并与 API 模型在同一评分体系下对比。项目整合 18,731 条已发布基准结果,每个模型拟合成一个分数,所有结果链接到来源;方法、数据、评分代码和实测 tok/s bench 脚本均已开源。作者称,一台 32GB Mac 可本地运行 4-bit 量化的 Qwen3.8 27B,得分与 GPT-5 相当且完全免费。该说法尚未经第三方复测。

解读这类工具的价值是把“本地能跑什么模型”从分散的 benchmark 整合成可查询的决策界面,但“18,731 条结果拟合成一个分数”的可信度取决于来源归一化方法。作者给出的 32GB Mac 本地持平 GPT-5 的结论,更像筛选提示而非已证实事实。

预计阅读 2 分钟
06
AWS Agent/开发者基础设施 aws 官方来源

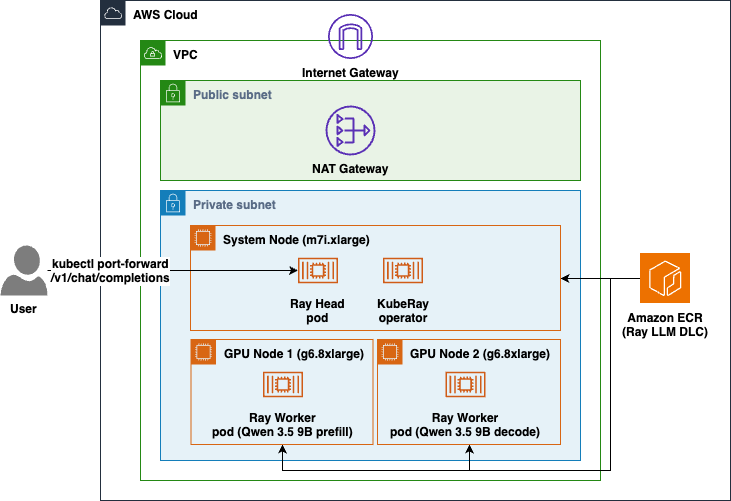
AWS 发布 Ray LLM 多节点推理容器指南:EKS 上 prefill/decode 分离部署 Qwen3.5-9B

AI SummaryAWS 官方博客介绍了用多节点 Ray LLM Deep Learning Containers 在 Amazon EKS 上部署单个大模型的方法:将 Qwen3.5-9B 分布在两个 GPU 节点(g6.8xlarge)上,一个负责 prefill、一个负责 decode,通过 NIXL 传输 KV cache、EFA 提供节点间高带宽互联,并对外暴露 OpenAI 兼容端点。容器预装 vLLM、Ray Serve、NIXL 与 EFA 栈,部署只需 YAML 配置而无需业务代码;配置中必须指定 NIXL 的 LIBFABRIC 后端,否则会退回 UCX 的 TCP 速度。示例中重启模型加载从约 145 秒降至约 2 秒;GPU 节点组因 EFA 不能跨 AZ 而固定在单一可用区。

解读AWS 把多节点 prefill/decode 分离推理打包成 DLC,将分布式推理从“组装组件”变成“写 YAML”,这是推理基础设施产品化的一个信号。但 NIXL/EFA 的组合和单 AZ 限制意味着性能与可用性取决于专用网络,不应把博客数值当成通用基准。

预计阅读 2 分钟
07
Luckey Faraday Agent/开发者基础设施 IT之家 中文转述 · 原始出处未核验

开发者用AI智能体将《使命召唤:黑色行动2》移植为网页游戏,遭动视DMCA下架

AI Summary据IT之家引述TweakTown报道,开发者Luckey Faraday利用AI“氛围编程”(Vibe Coding)制作两款《使命召唤》网页游戏,被动视DMCA投诉下架。项目《Claude of Duty:Vibe Slops II》基于《黑色行动2》多人模式,含Hijacked与Nuketown 2025两张地图,玩家可与6个AI机器人对战;《Kino der Toten》复刻经典僵尸地图。两项目均使用AI智能体与Three.js开发,开发者声明与动视、Treyarch、微软、Anthropic无关,但用了原版地图、模型和动画素材,故遭投诉下架。

解读AI编程工具把游戏逆向工程和网页移植变成低成本个人项目,但技术门槛下降不豁免版权责任——使用原版素材的非官方移植仍会被权利方快速下架。Vibe Coding降低的是实现成本,不是合规成本。

预计阅读 70 秒
08
Meta 模型/产品发布 Meta 官方来源

Meta 于 OCP 2026 公布液冷 102.4T 交换机、FPF 多平面网络与以太网 Scale-Up 方案

AI SummaryMeta 在 2026 OCP 全球峰会公布新一代开放网络基础设施:液冷机架 IcePack(基于 ORV3-HPRv1)搭载 102.4T 交换机 IceCube,提供 128×800G 无阻塞交换,分 Broadcom Tomahawk6C 与 NVIDIA Spectrum-6 两个版本;FPF 多平面扩展架构让每颗 GPU 经 8 条独立 100G 链路接入 8 个平面;为 MTIA 300 打造的 Tahan 是 51.2T 以太网 scale-up 交换机,4 台互连 16 颗加速器;MetaRoCE 已开源,OSPA v1.0 由 Meta、微软、阿里共同提交 OCP。

解读Meta 借 OCP 峰会持续把自研 AI 网络推向行业标准:液冷 102.4T 交换机、8 平面 100G NIC 喷洒、以太网 scale-up,本质是服务吉瓦级 GPU 集群的网络成本与故障域控制。FPF 把控制面从交换机扩展到宿主、负载均衡下沉到 NIC,比单纯堆带宽更难复制。

预计阅读 75 秒
C

行业观点

X 大 V · YouTube / Podcast · Builder 观察 · 开发者讨论

01
levie 行业动态 XAaron Levie

解读这是一张行业认知地图而非新闻:Levie 把“聊天机器人式使用”与“agent swarm 式工作流”之间的鸿沟定义为 AI 应用层的核心机会。判断有洞察,但渗透率和成本论述均无数据支撑,引用 Andrej 的框架无法核实原文,宜作观点而非趋势证据。

预计阅读 5 分钟