基础模型与技术
AI DAILY BRIEF · EVENT NOTES · 2026.06.13
for AI era builders
EDITORIAL BRIEF
AI 行业简报 2026-06-13
今天筛出 15 个事件:大厂动态 5 条,技术进展 4 条,行业观点 6 条;另读 Hugging Face Papers 5 篇。
TOP 3 · 今日重点
先读重要变化,再看技术细节行业 / 商业动态
Anthropic:SpaceX, Anthropic, and OpenAI’s hot IPO summer
阅读解读与来源 →行业 / 商业动态
36氪研究院
阅读解读与来源 →按主题查阅 15 个事件
行业 / 商业动态4
AI 产品与工具3
Agent 技术1
工程实践0
本期暂无达到入选标准的新内容
AI + 行业赋能0
本期暂无达到入选标准的新内容
A
大厂动态
AI 公司动态 · 模型发布 · 新业务 · 融资投资 · 人员变动
MCP:Build 2026:Azure API Management 推出统一模型API并新增MCP内容安全能力
事实摘要
微软 Build 2026 宣布 Azure APIM 推出统一模型 API,实现多厂商接口自动适配,并将内容安全与词元统计扩展至 MCP 调用及智能体通信场景。
编辑解读
微软正将传统 API 网关演进为 AI 工作负载控制平面,通过协议抽象与治理复用抢占企业智能体基础设施入口。
预计阅读 30 秒
Anthropic:SpaceX, Anthropic, and OpenAI’s hot IPO summer
事实摘要
该播客探讨 2026 年 IPO 热潮,指出市场焦点转向 Anthropic、OpenAI 与 SpaceX 等新阵营,并分析多家公司同期上市对估值体系的压力测试。
编辑解读
资本叙事正从技术竞赛转向二级市场流动性博弈,密集上市将暴露算力成本与商业化兑现的真实差距。
预计阅读 30 秒
Anthropic:It’s hot IPO summer, and the MANGOS are ripe
事实摘要
报道指出IPO市场回暖,以Anthropic、OpenAI等为代表的“MANGOS”新巨头正取代FAANG,其中半数企业计划近期上市,将对资本市场估值与投资者承受力构成压力测试。
编辑解读
资本叙事正从技术竞赛转向公开市场流动性博弈,高估值能否兑现取决于算力成本与商业化现金流的真实匹配度。
预计阅读 30 秒

宇瞻推出 GraTherX 内存条散热技术:每侧加厚 0.17mm,故障率降低 60%
事实摘要
宇瞻发布面向边缘AI的GraTherX内存散热方案,采用石墨烯-铜复合材料,宣称仅加厚0.17mm即可在无风扇环境下降低热点温度并减少60%故障率。
编辑解读
该方案属边缘硬件可靠性优化,不改变大模型推理架构,需验证高负载DDR5下的长期热衰减与真实良率。
预计阅读 30 秒

支持离线运行,苹果 iPhone 17 Pro 等升级 iOS 27 后支持 AI 高级听写功能
事实摘要
苹果在 iOS 27 Beta 1 中推出“高级听写预览”功能,该功能完全依赖本地模型离线运行,提升语音转写准确率与标点处理,仅适配 M3 及以上芯片及 12GB 内存设备。
编辑解读
苹果通过端侧算力门槛筛选用户,将语音转写从云端转向本地推理,实质是硬件溢价与隐私合规的平衡。
预计阅读 35 秒
B
技术进展
Hugging Face · 技术报告 · 论文 · Benchmark · RL 研究
HF PAPERS
查看当天论文
Hugging Face Papers 速读
逐篇读取当天 paper 页面,由 qwen3.6-plus 生成中文摘要。
动态环境中LLM智能体记忆演化追踪 (EvoArena & EvoMem)
研究摘要
提出EvoArena动态环境基准与EvoMem补丁式记忆机制,使智能体能随环境变化持续更新知识与行为。
智能体动态环境记忆机制

MiniMax稀疏注意力机制 (MiniMax Sparse Attention)
研究摘要
提出基于GQA的分块稀疏注意力MSA,配合定制GPU内核,在百万级上下文下大幅降低计算量并提升推理速度。
稀疏注意力超长上下文推理加速


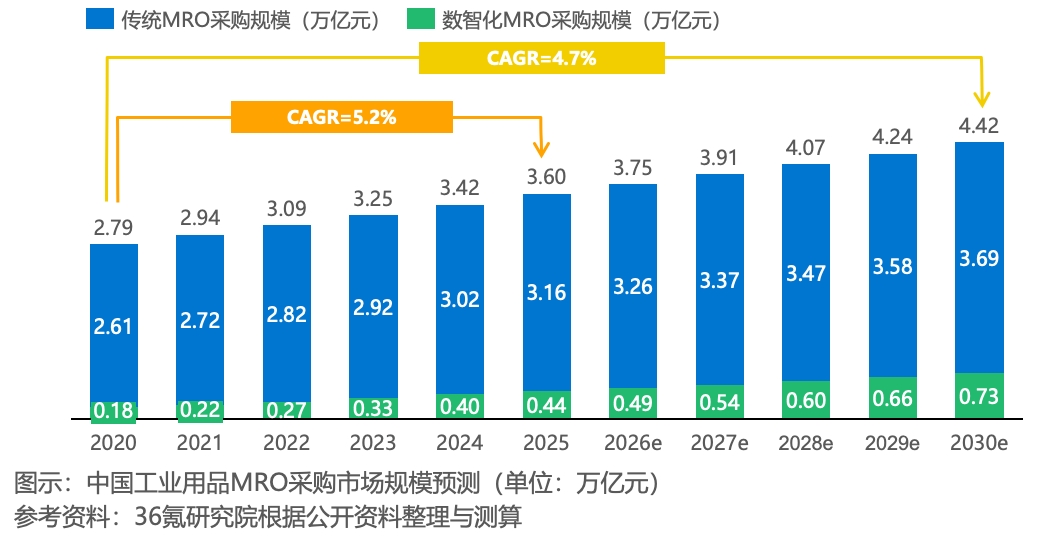
36氪研究院
事实摘要
报告指出中国工业MRO采购市场正从线上交易转向供应链协同,AI已深入商品治理、智能选型与库存优化等环节,成为平台升级的核心驱动力。
编辑解读
AI在此是工程底座而非颠覆技术,本质是将非结构化工业数据转化为可计算资产,落地高度依赖高质量语料与业务闭环。
预计阅读 25 秒
Snowflake 迈向 Agentic Enterprise 的关键一跃
事实摘要
报道详述Snowflake发布CoCo与CoWork双引擎、原生流处理及智能体治理策略,阐述其将数据平台升级为企业级智能体可信运行与控制中枢的布局。
编辑解读
智能体竞争已从模型能力转向数据治理与行为管控,Snowflake正借数据底座卡位Agent基础设施入口。
预计阅读 25 秒

OpenAI:Siri won’t be your AI girlfriend
事实摘要
报道引述苹果高管访谈,指出新版Siri在设计上刻意避免讨好型人格与情感陪伴功能,明确拒绝成为“AI伴侣”,转而聚焦于高效完成任务。
编辑解读
苹果选择工具型对齐路线,本质是以隐私与效率为护城河,对抗大模型厂商依赖情感粘性与数据收集的留存策略。
预计阅读 30 秒
olmo-eval: An evaluation workbench for the model development loop
事实摘要
Ai2发布olmo-eval评测工作台,专为LLM迭代开发设计。该工具提供模块化组件与逐Prompt对比分析,帮助开发者在频繁调参时快速验证干预效果并区分真实提升与统计噪声。
编辑解读
评测范式正从静态发榜转向开发过程诊断,核心是用细粒度统计与模块化架构降低迭代试错成本。
预计阅读 30 秒
C
行业观点
X 大 V · YouTube / Podcast · Builder 观察 · 开发者讨论
had an idea for a big fable project, set it up, and let it cook came back an hour later and it had triggered the safeguards and fell back to 4.8 10 minutes in back to codex 😬
编辑解读
长程编码 Agent 的安全对齐与状态保持机制尚未成熟,复杂工作流极易触发强制降级,免干预交付仍存架构瓶颈。
预计阅读 60 秒
Replit Agent team did a great job making Fable cost stomachable. The lack of mistakes net net makes it more affordable. https://t.co/ICkFYKxqYt
编辑解读
Agent的经济性核心不在模型单价,而在低错误率带来的返工与调试成本骤降,可靠性才是规模化落地的关键。
预计阅读 50 秒
For the first time, I'm vibecoding with ZERO frustration and in a complete state of flow, so much so that I'm running out of ideas. Typically, I have so much backlog of things I want to add, but after Fable landed on Replit, I'm almost certain I don't need more IQ for vibecoding, just cheaper and faster models, and we're done here.
编辑解读
本质是 Agent 能否从演示走向可交付工作流,关键看它减少了多少人工接线和返工。
预计阅读 70 秒
This is what building a company looks like on Replit. One canvas with your web app, mobile app, marketing & App Store material. Click into any one of those and start building, changing, and generating new things. https://t.co/gX7qCakTOe
编辑解读
本质是公司资源正在重新下注,重点看钱、人和入口是否真的向这条线迁移。后续只看可验证结果:采用、收入、复现或独立评测。
预计阅读 60 秒