基础模型与技术
AI DAILY BRIEF · EVENT NOTES · 2026.07.14
for AI era builders
EDITORIAL BRIEF
AI 行业简报 2026-07-14
今天筛出 15 个事件:大厂动态 5 条,技术进展 2 条,行业观点 8 条;另读 Hugging Face Papers 5 篇。
TOP 3 · 今日重点
先读重要变化,再看技术细节Agent 技术
Bluesight:Building an agentic AI solution at Bluesight with Amazon Bedrock
阅读解读与来源 →工程实践
阶跃星辰:【钛晨报】李强主持召开经济形势专家和企业家座谈会;Meta宣布将追加400亿美元投资路易斯安那州数据中心;字节跳动回应:没有做智能驾驶业务的计划
阅读解读与来源 →按主题查阅 15 个事件
行业 / 商业动态0
本期暂无达到入选标准的新内容
Agent 技术4
- Bluesight:Building an agentic AI solution at Bluesight with Amazon Bedrock
- Meta:小扎“消失”三年后发帖,只为它:Meta最强Agent模型进军编程,从免费开源到卖“低价”模型
- AutoWorldBuilder:Fictional Worldbuilding: Multi-Agent LLM Collaboration with Hierarchical Context Compression and Iterative Review
- Google DeepMind:Scoped Verification for Reliable Long-Horizon Agentic Context Evolution under Distribution Shift
AI + 行业赋能0
本期暂无达到入选标准的新内容
算力硬件与基础设施0
本期暂无达到入选标准的新内容
政策、安全与社会影响0
本期暂无达到入选标准的新内容
人才与组织0
本期暂无达到入选标准的新内容
A
大厂动态
AI 公司动态 · 模型发布 · 新业务 · 融资投资 · 人员变动
OpenAI:OpenAI GPT-5.6 Sol, Terra, and Luna are now generally available on Amazon Bedrock
事实摘要
OpenAI GPT-5.6 Sol、Terra、Luna 三款模型在 Amazon Bedrock 上正式可用,支持 prompt caching 和硬件级安全,定价与 OpenAI 直接 API 一致。
编辑解读
OpenAI 通过 AWS 渠道分发旗舰模型,强调推理效率和安全性,但 benchmark 分数需独立验证。
预计阅读 30 秒
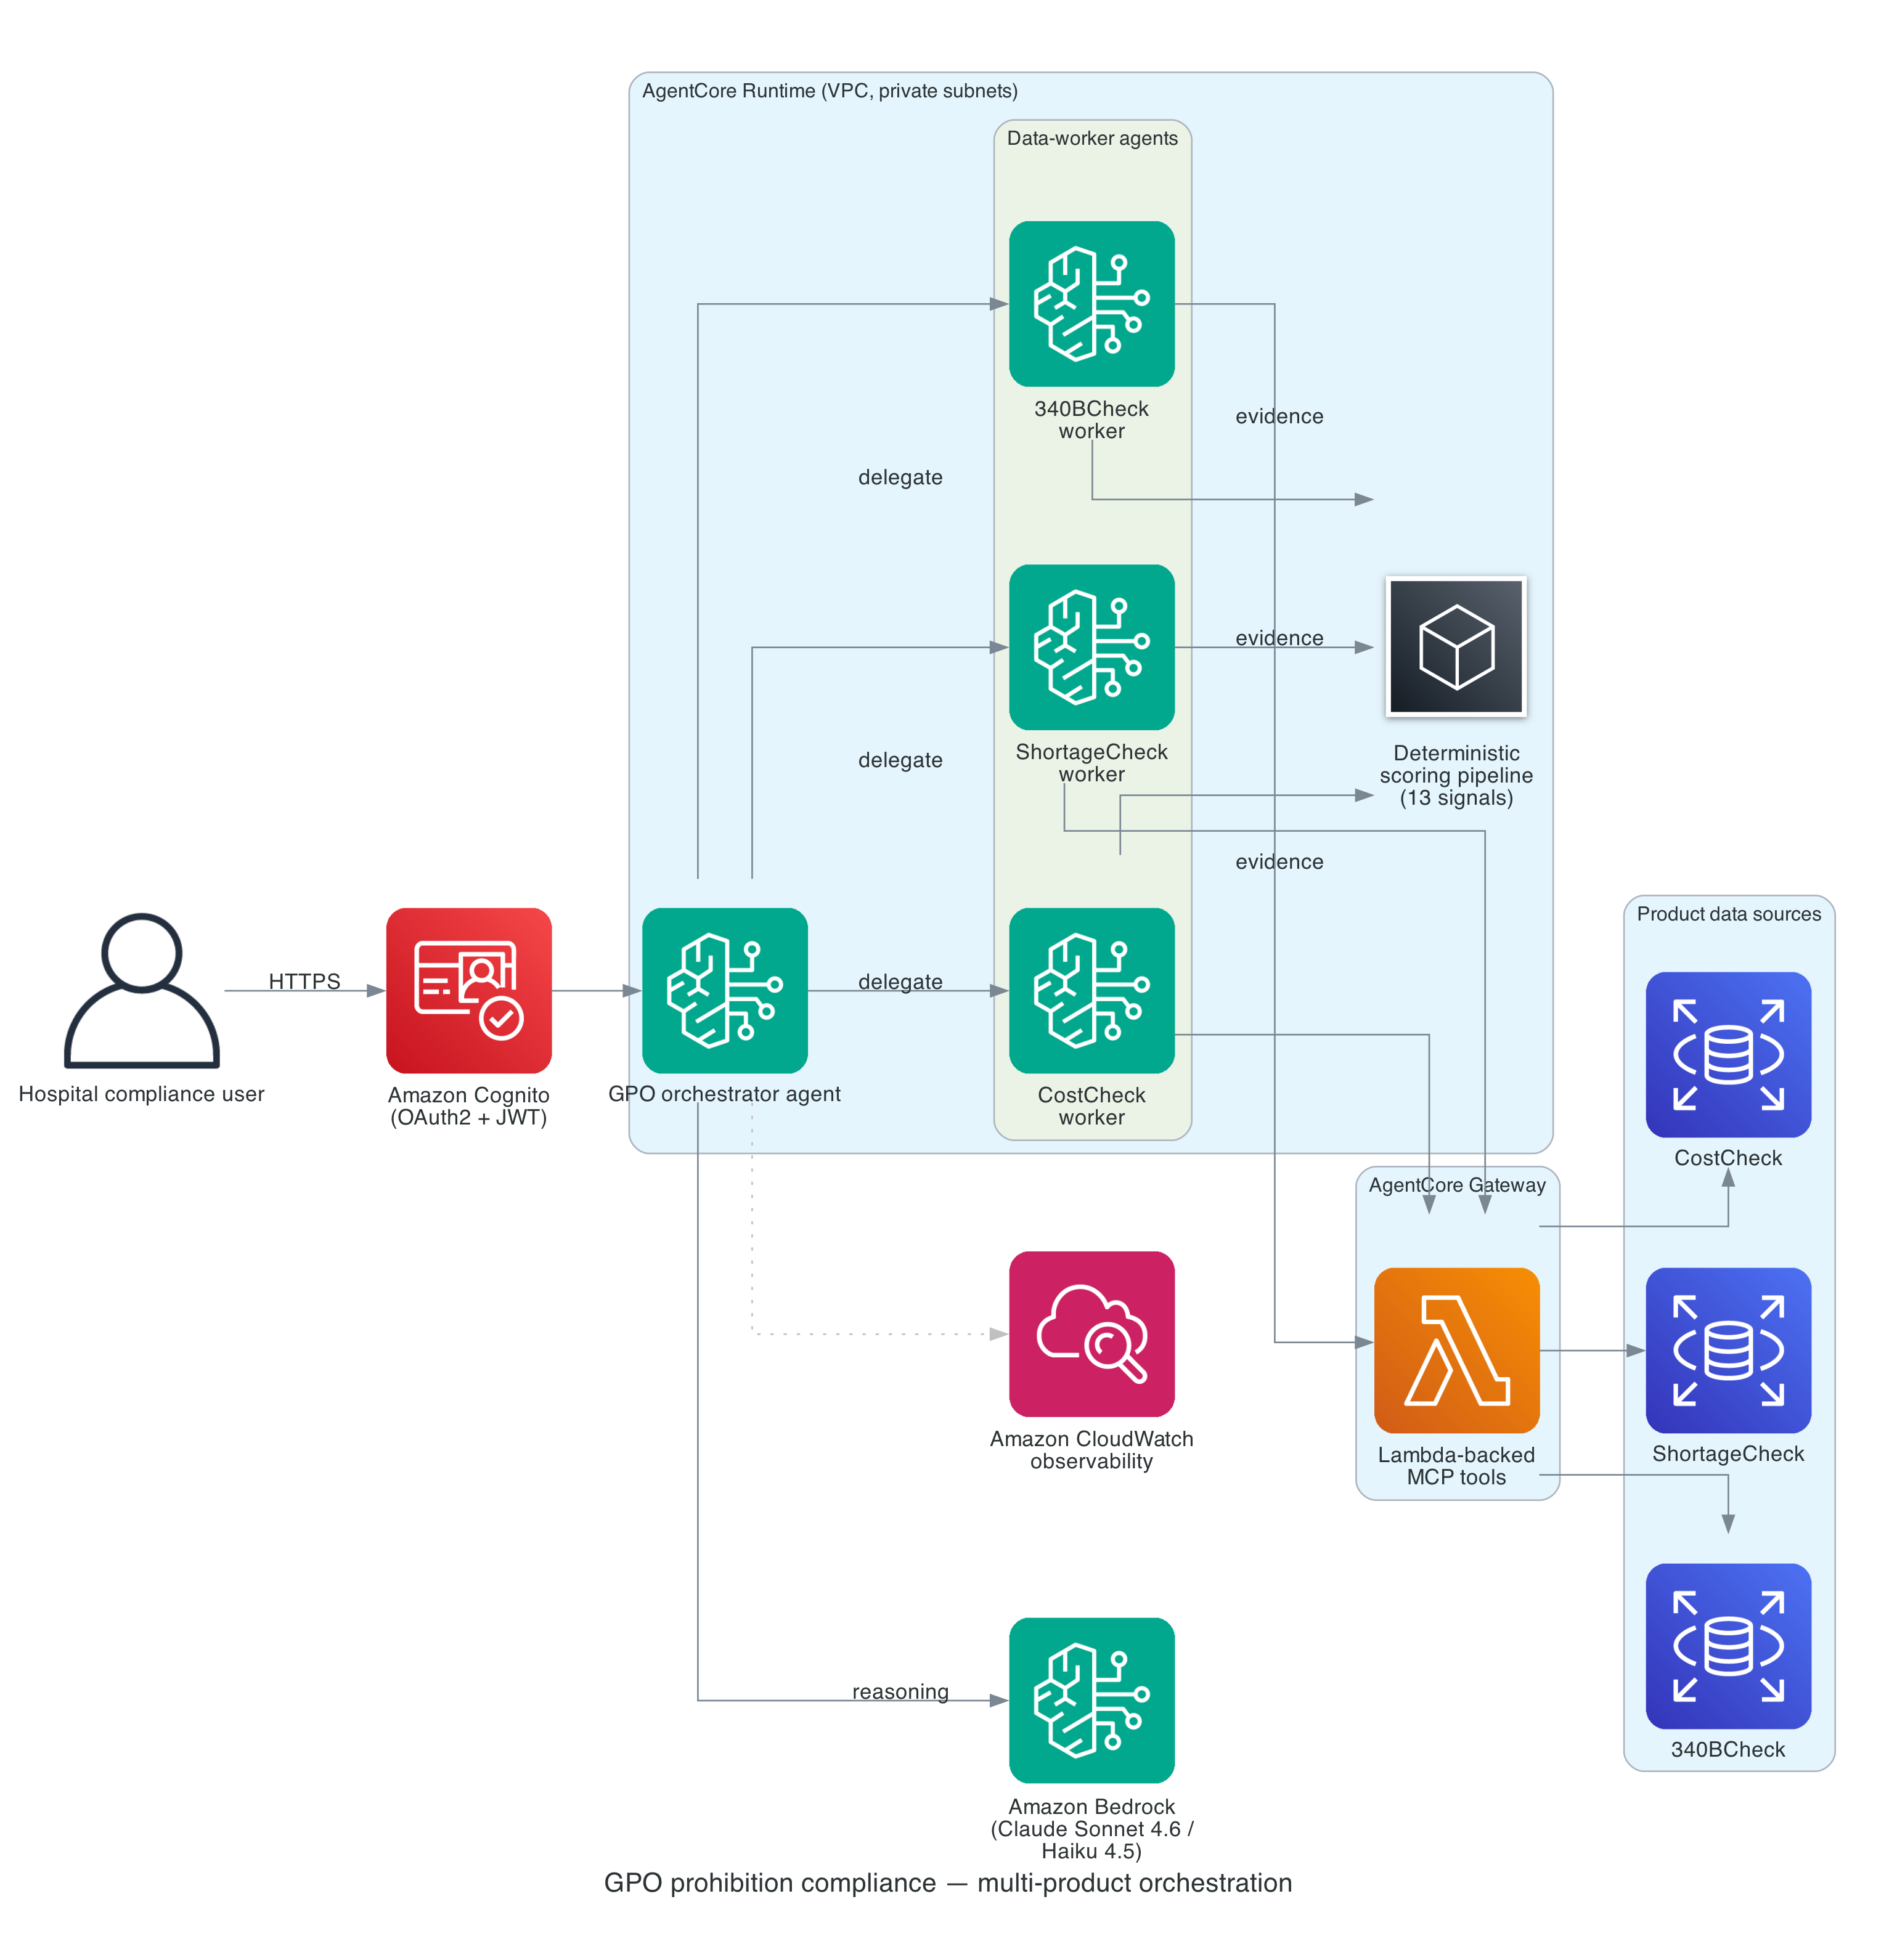
Bluesight:Building an agentic AI solution at Bluesight with Amazon Bedrock
事实摘要
Bluesight 使用 Amazon Bedrock AgentCore 构建了 Prism,一个覆盖六个医疗合规产品的统一 agentic AI 解决方案,ControlCheck 版本已上线并被 20 家医院使用。
编辑解读
医疗合规场景的 agent 落地案例,关键是将 LLM 推理与确定性规则分离,满足 HIPAA 要求。
预计阅读 30 秒

阶跃星辰:【钛晨报】李强主持召开经济形势专家和企业家座谈会;Meta宣布将追加400亿美元投资路易斯安那州数据中心;字节跳动回应:没有做智能驾驶业务的计划
事实摘要
阶跃星辰发布全球首款大模型原生智能体手机,搭载Step AOS和智能体Amoo,将于WAIC首秀。
编辑解读
模型厂商从软件走向硬件入口,但手机形态能否跑通Agent场景仍需验证。
预计阅读 25 秒

Waze:Waze is getting a bunch of new AI-powered features
事实摘要
Waze集成Google Gemini,新增对话式事故报告、目的地搜索、更简洁语音模式、摩托车模式及基于历史路线的个性化建议。
编辑解读
本质是Google将Gemini能力注入Waze,提升导航交互的自然度,但功能仍属渐进式改进,未改变导航核心体验。
预计阅读 25 秒

Meta:小扎“消失”三年后发帖,只为它:Meta最强Agent模型进军编程,从免费开源到卖“低价”模型
事实摘要
Meta 发布 Muse Spark 1.1,面向智能体编程的多模态模型,定价低于竞品,扎克伯格时隔三年发帖宣传,计划开源变体版本。
编辑解读
Meta 用低价策略切入 AI 编码市场,但开源承诺与商业化 API 的平衡仍需观察。
预计阅读 30 秒
B
技术进展
Hugging Face · 技术报告 · 论文 · Benchmark · RL 研究
HF PAPERS
查看当天论文
Hugging Face Papers 速读
逐篇读取当天 paper 页面,由 deepseek-v4-flash-260425 生成中文摘要。

Long-Horizon-Terminal-Bench:长时终端任务智能体基准测试
研究摘要
提出包含46个长时任务的终端基准,采用密集奖励评分,评估15个前沿模型,最强模型通过率仅15.2%。
智能体基准测试长时任务

Scalable Visual Pretraining for Language Intelligence(可扩展视觉预训练用于语言智能)
研究摘要
论文页面正在讨论中,暂无详细摘要。
视觉预训练语言智能


AutoWorldBuilder:Fictional Worldbuilding: Multi-Agent LLM Collaboration with Hierarchical Context Compression and Iterative Review
事实摘要
提出AutoWorldBuilder多智能体系统,通过四层上下文压缩(90% token减少)和迭代审查(通过率从42%升至85%+),解决虚构世界构建中的上下文爆炸与一致性问题,在20个任务上达95%成功率。
编辑解读
多智能体协作中上下文压缩和迭代审查是实用工程模式,但虚构世界构建任务本身是否具有代表性值得商榷。
预计阅读 35 秒
Google DeepMind:Scoped Verification for Reliable Long-Horizon Agentic Context Evolution under Distribution Shift
事实摘要
Google DeepMind 提出 GRACE 方法,用图结构维护 agent 上下文指令,在分布偏移下将电信任务可靠性从 0.091 提升至 0.673,超过 Gemini 3.1 Pro。
编辑解读
用图结构替代扁平文本维护 agent 指令,使验证局部化,解决了长期上下文演化中的可靠性瓶颈。
预计阅读 30 秒
C
行业观点
X 大 V · YouTube / Podcast · Builder 观察 · 开发者讨论
OpenAI:I loved ChatGPT Desktop until OpenAI gutted it to make room for Codex and Work
事实摘要
OpenAI 将 ChatGPT 桌面应用与 Codex 合并,移除了截图和“Work With”等便捷功能,作者认为这是为了推广更贵的 Pro 计划。
编辑解读
OpenAI 为推广高价值 agent 产品牺牲了普通桌面用户体验,暴露产品策略与用户需求的冲突。
预计阅读 30 秒

DeepSeek:程序员面试背了十年的八股文,被DeepSeek废了
事实摘要
文章分析DeepSeek面试风格:两轮纯代码面试,只问线上实战问题,淘汰八股文套路;并与字节、腾讯面试哲学对比。
编辑解读
DeepSeek用代码面试筛选实战能力,本质是反八股文、反包装,但能否规模化复制存疑。
预计阅读 25 秒
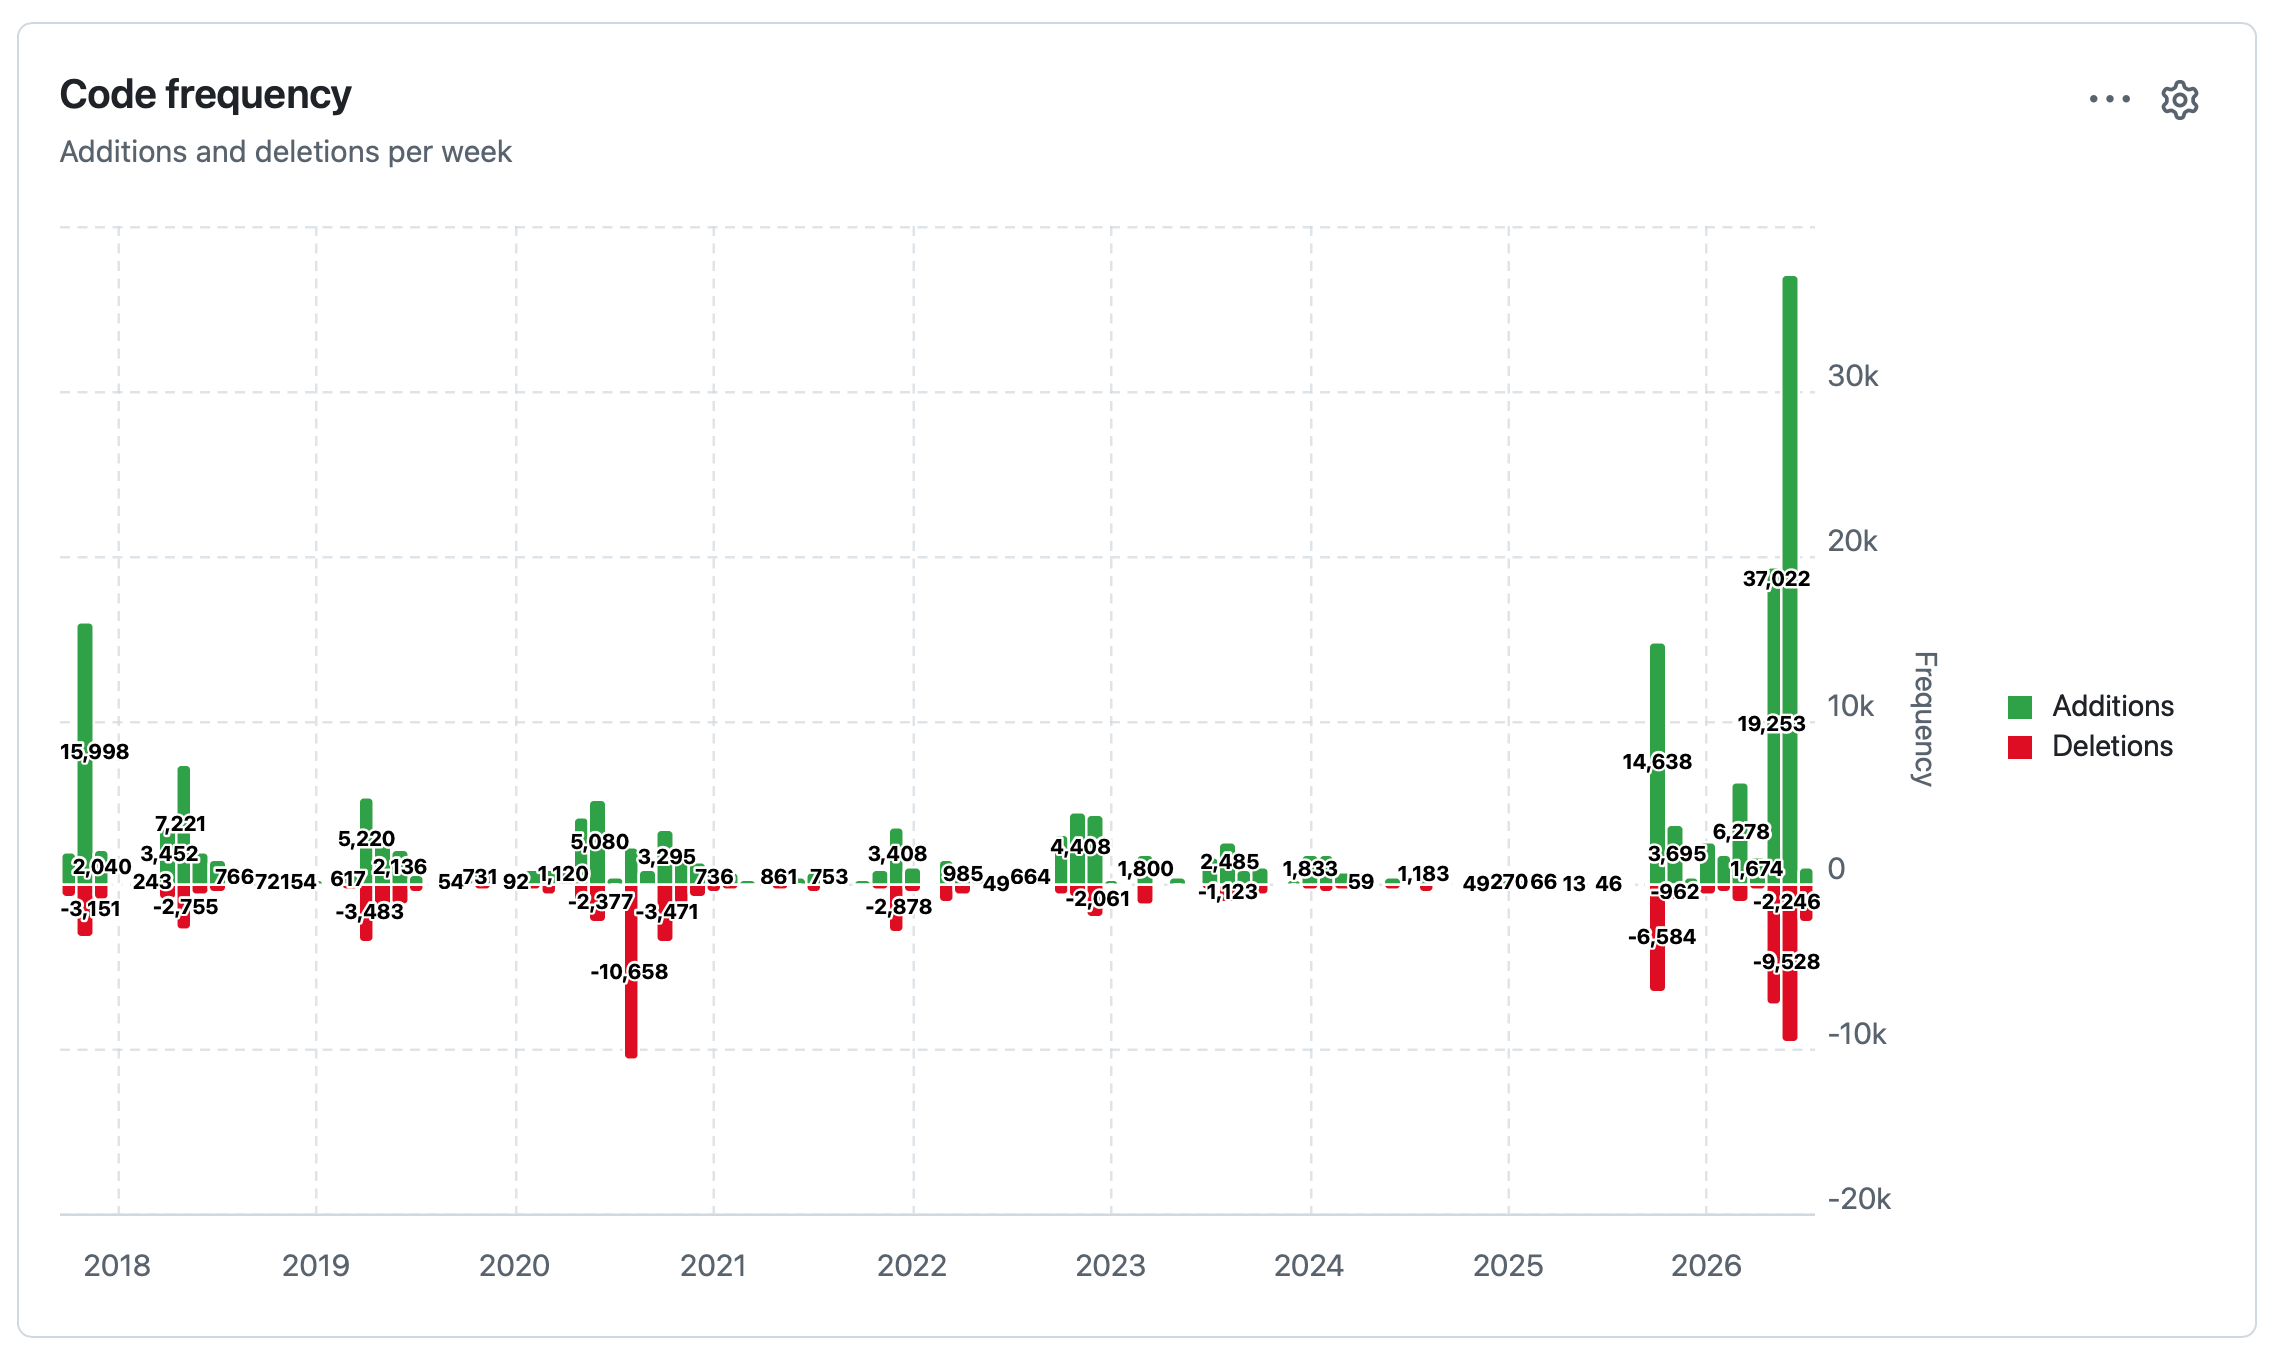
Simon Willison:datasette code-frequency chart on GitHub
事实摘要
Simon Willison 通过 GitHub 代码频率图表发现,AI 编码代理和高级模型(如 Opus 4.8、GPT-5.5 等)显著提升了他的 Datasette 项目代码提交频率。
编辑解读
个人开发者视角下 AI 编码工具对产出效率的可视化影响,样本单一,不能泛化。
预计阅读 25 秒
Anthropic makes great models too but I don't understand why they communicate like this. I think they need to engage the community more directly like what OpenAI is doing. https://t.co/BqYu5FglYV
编辑解读
Anthropic 在社区沟通策略上被批评过于保守,与 OpenAI 的开放形成对比。
预计阅读 50 秒