AI DAILY BRIEF · EVENT NOTES · 2026.10.10 for AI era builders

EDITORIAL BRIEF

AI 行业简报 2026-10-10

今天筛出 15 个事件:大厂动态 10 条,技术进展 5 条,行业观点 0 条;另读 Hugging Face Papers 5 篇。

A

大厂动态

AI 公司动态 · 模型发布 · 新业务 · 融资投资 · 人员变动

01
华为 模型/产品发布 IT之家

华为发布鸿蒙电脑9月体验报告,DevEco三件套鸿蒙PC版公测启动(DevEco Code内置GLM5.3/5.1)

AI Summary华为在花粉俱乐部发布鸿蒙电脑9月体验报告,新增沉浸光感、图库AI修图、小艺任务模式、动态壁纸等。同期DevEco Studio上线上鸿蒙PC并开启公测,DevEco Code与DevEco CLI同步迎来鸿蒙PC版首次公测,2026年10月8日启动,要求MateBook Pro、MateBook Fold非凡大师等机型,系统为HarmonyOS 7.0.0.107及以上、内存16GB及以上。DevEco Code内置GLM5.3和GLM5.1模型,提供Plan、Build、Goal三种模式。小艺任务支持多智能体协同架构,拥有4大类2300+项技能,据华为官方称其端侧WebAgent任务成功率持平人类水平。另据华为高管预告,首款鸿蒙台式机擎云HM650系列计划2026年10月上市,搭载麒麟X90芯片,面向政企商用场景。

解读鸿蒙PC这次不只是系统UI更新,真正重要的是DevEco三件套公测:华为把Agentic编码链路搬上桌面生态,且DevEco Code直接内置GLM模型而非自研模型,说明工具链选型更务实。小艺任务的端侧多智能体架构则与云端Agent形成对照。

预计阅读 2 分钟
02
豆包工作 模型/产品发布 雷峰网

豆包工作新增画布功能,并接入豆包2.1 Lite模型

AI Summary豆包工作新增创作画布功能,将素材、设计方案与创作成果集中到同一页面,用户可在无限画布上快速查看、对比和整理,生成图片后仍能继续修改文字、配色与布局。该功能同时接入图片模型 Seedream 5.0 Flash,Agent 可从理解需求、规划方案直至完成图片、视频和成套设计。模型侧新增轻量级豆包 2.1 Lite,面向日常问答、文档撰写、表格处理和 PPT 制作等高频办公场景,优化响应速度与额度消耗,并在多模态理解上有所提升。豆包工作自 8月25日发布以来保持每周更新,此前已推出多 Agents 并行、Mac 端操作电脑、浏览器录屏回放、目标模式和计划模式等功能。

解读画布把多模态生成从单次出图升级为可迭代的工作台,Lite 模型则用更低成本覆盖高频办公场景。豆包工作周更节奏显示字节在办公 Agent 上快速试错,但官方口径仍缺独立评测,能否嵌入真实工作流待验证。

预计阅读 2 分钟
03
田柯宇 融资/收购/估值 雷峰网

争议创始人田柯宇获五源与IDG 3000万美元融资,用20万符号“视觉词典”做世界模型,估值2亿美元

AI Summary据雷峰网报道,曾涉2024年字节训练干扰事件的田柯宇,其10人团队实验室获五源资本与IDG 3000万美元投资,估值2亿美元。田柯宇是NeurIPS 2024最佳论文VAR一作,新项目以20万符号“视觉词典”压缩并预测视频,宣称每秒视频生成成本可降低至少一个数量级,计划用约1亿小时视频训练,2027年发布面向机器人、自动驾驶和交互式视频的基座模型。字节曾索赔800万元,法院最终判其违反实习合同,赔偿50万元并返还实习工资。

解读资本把争议与路线分开定价:五源与IDG押注的是符号化压缩能否把视频生成成本降一个数量级,而非对田柯宇过往行为的背书。这轮融资第一次给‘纯自回归符号世界模型’定出2亿美元估值锚点,但方案本身还没有公开验证。

预计阅读 70 秒
04
小米 公司/行业动态 IT之家

小米发布 MiMo-V2.5 与 V2.5-Pro 下线通知:10月14日自动切换至 V2.6,21日旧名失效

AI Summary小米于10月9日发布 MiMo-V2.5-Pro 与 MiMo-V2.5 模型下线通知。下线分两步:2026年10月14日18:00起,调用旧模型请求自动转发至 MiMo-V2.6 对应模型(v2.5-pro→v2.6-pro,v2.5→v2.6-flash),并按新版模型计价;10月21日10:00旧名称正式失效,继续调用将报错。通知建议开发者在此之前完成迁移和测试。据IT之家,V2.6系列已于9月22日发布并开源,定价沿用V2.5:Flash 输入1元/百万词元、输出2元/百万,Pro 3元/6元,并提供99%缓存折扣;同等智能水平下价格约为海外模型的1/20至1/60。

解读这不是模型能力的重大更新,而是标准API版本淘汰:开发者只有两周窗口完成迁移,10月14日切流、21日旧名失效。真正有信息量的是MiMo-V2.6已开源且定价延续,但性价比宣称来自厂商口径,榜单排名需独立复现。

预计阅读 75 秒
05
OpenAI Agent/开发者基础设施 OpenAI

OpenAI 发布 Asana 浏览器 Agent 案例:用 GPT-6 将测试成本降低 76 倍、速度提升 5 倍

AI SummaryOpenAI 官网发布客户案例称,Asana 在 Codex 中使用 GPT-6(页面标题写作 GPT-6.1 Sol,正文摘要称 GPT-6 Astra)将其浏览器 Agent 在测试中成本降低 76 倍、速度提升 5 倍,目的是向客户提供更强大的模型。该案例为 OpenAI 单方发布的测试结果,未公开测试任务、数据集、成本计算口径和硬件条件,也未提供可复现的基准细节。

解读这是 OpenAI 官网的客户成功案例,本质是营销材料而非独立评测。'76 倍成本下降'来自厂商单方测试,缺乏方法细节,只能作为市场信号,不能当作通用基准。

预计阅读 55 秒
06
JetBrains 模型/产品发布 IT之家

JetBrains 发布编程模型 Mellum2.1:强化学习成为训练主体,高负载吞吐接近 Qwen3.5-9B 两倍

AI SummaryJetBrains 于 10 月 8 日发布编程模型 Mellum2.1(Apache 2.0),沿用 Mellum2 的 12B MoE 架构、2.5B 活跃参数。核心改动是把预训练后的强化学习从收尾环节扩展为训练主体,补充数学、算法竞赛、科学、工具使用和软件工程数据,并自建沙盒基础设施,训练期间启动数百万个沙盒。新模型可探索代码库、编辑文件并检查自身修改。官方对比显示:MTP 让单请求响应速度提升约 1.6 倍;相同评估设置下,高负载推理吞吐接近 Qwen3.5-9B 的两倍。模型已上架 Hugging Face,后续将推出 GGUF 版与 vLLM MTP 组件。

解读JetBrains 把强化学习从可选的收尾步骤升级为训练主体,并用大规模沙盒仿真补齐 agent 编程训练数据,方向信号比单点指标更重要;吞吐优势主要来自 MTP 推测解码和官方自测,需独立复现后再评估模型真实水位。

预计阅读 2 分钟
07
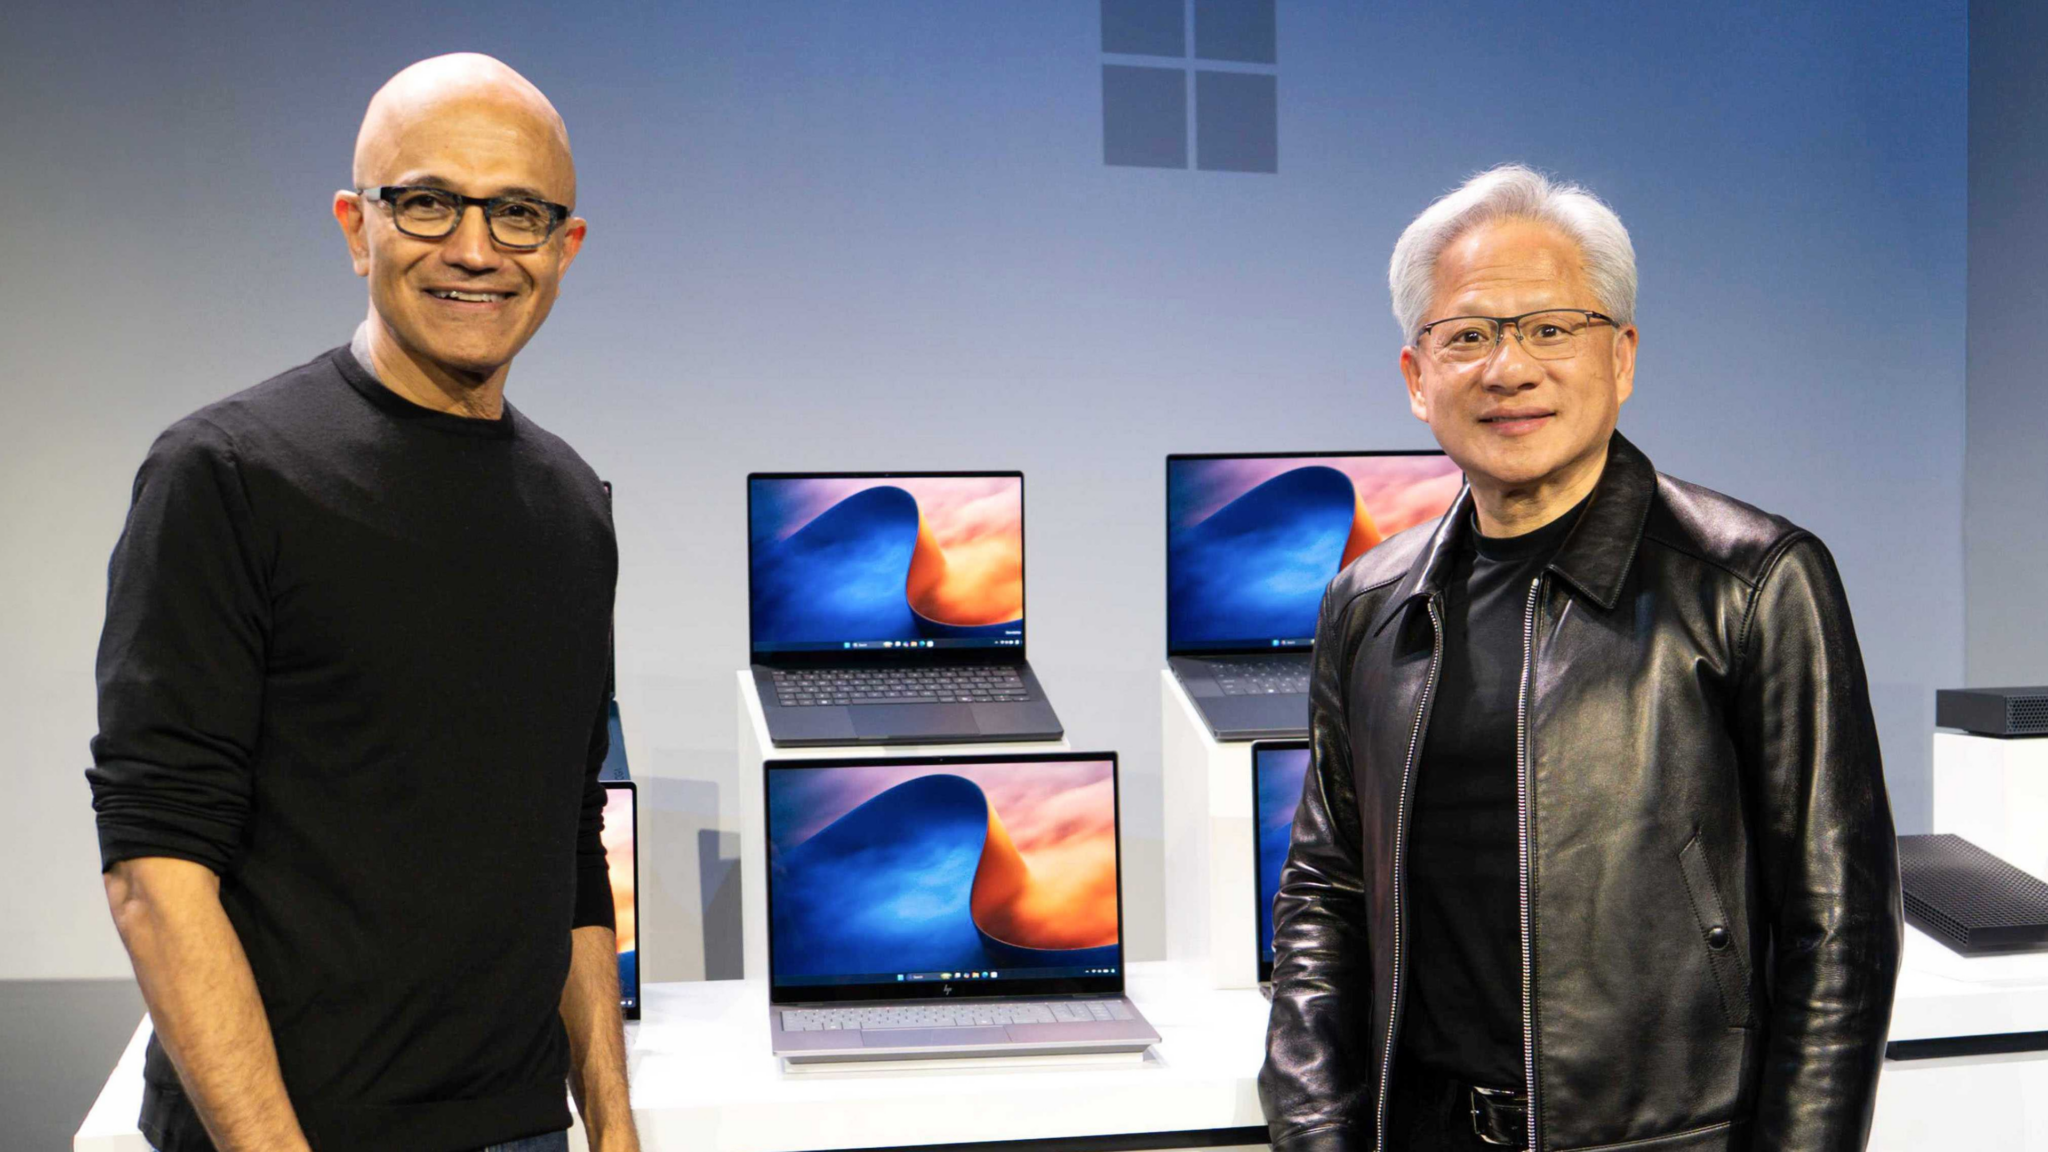
微软 模型/产品发布 IT之家

微软发布 Microsoft-Decision-1 决策模型:基于 Qwen3.5-9B 后训练,接入 OpenRouter

AI Summary当地时间 10 月 9 日,微软发布专为结构化决策任务打造的 Microsoft-Decision-1 模型,已上线 Microsoft Foundry 并接入 OpenRouter。官方称该模型基于 Qwen3.5-9B 进行后训练,实现超低延迟的单次推理决策评分机制,后续将迁移适配至 Microsoft AI(MAI)和 OpenAI 等其他底座模型。在 36 项基准测试、涵盖近 15 万个训练阶段完全隔离(Blind Evaluation)的测试中,微软称其准确率最高;响应速度比 Quyet-1.0-Large 快 4.5 倍、比 GPT-6 Sol 快 35 倍。安全评测涵盖 11 项基准、共 5,250 条请求,覆盖有害内容、越狱攻击及提示词注入。定价为每百万 Token 输入 0.042 美元(约合 0.28 元人民币),输出免费。

解读微软用 Qwen 开源底座做垂直决策评分模型,本质是裁剪推理路径换取极致延迟和成本,而非通用能力比拼。这也说明在窄任务上,小底座后训练可以代替大模型,开源底座正在反向进入云厂商的商业产品线。

预计阅读 2 分钟
08
LangChain Agent/开发者基础设施 LangChain Engineering

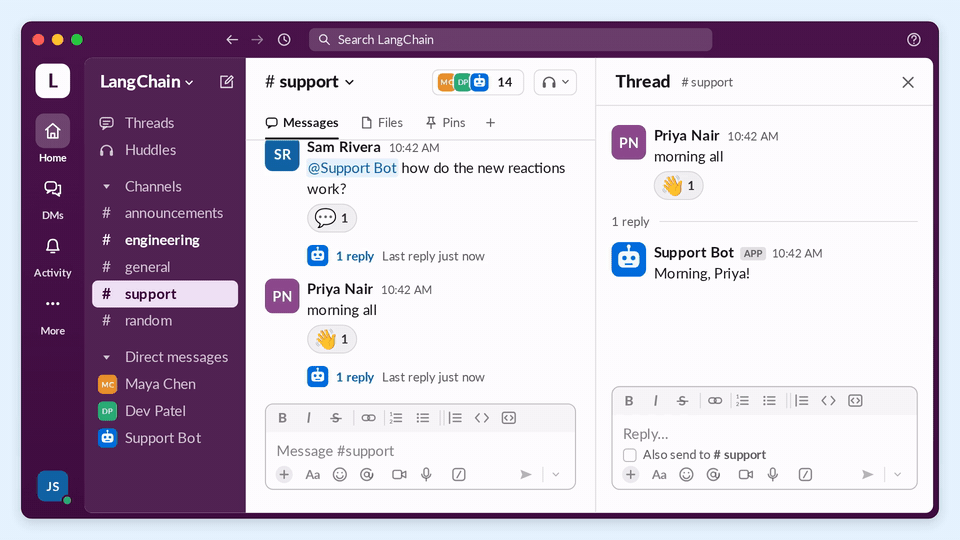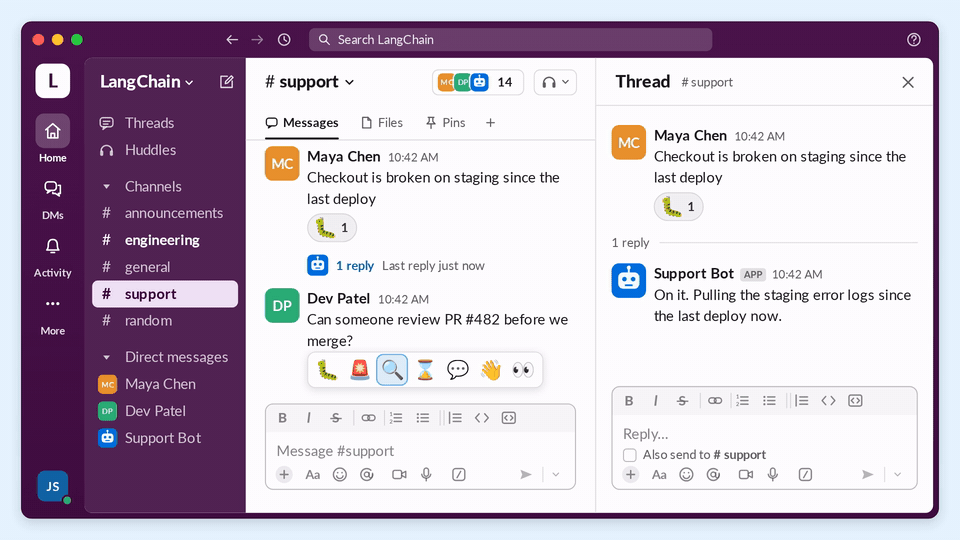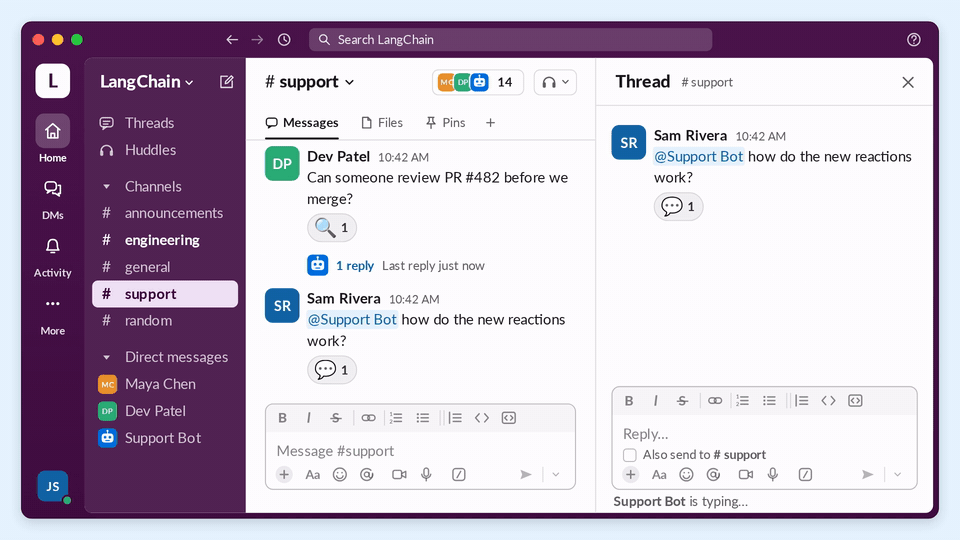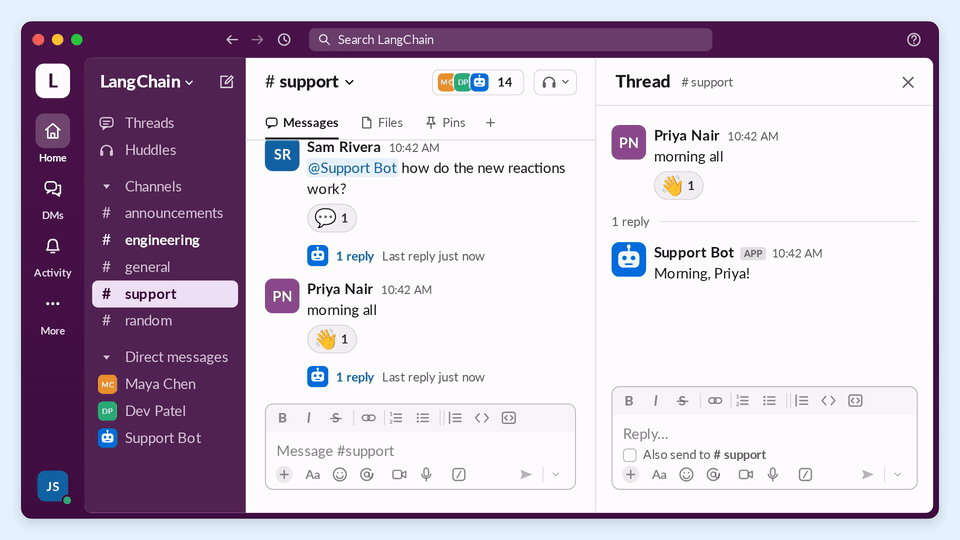
LangChain 为 Managed Deep Agents v0.9 发布 Slack reactions API,支持用决策模型动态生成 emoji 状态反馈

AI SummaryLangChain 官方博客发布 Managed Deep Agents v0.9 新增的 reactions API:开发者可为 Slack 通道配置一个 emoji 字符串或返回 emoji 的函数,以构建 Agent 的 loading 状态和任务接收确认。实现既可用 if-else、静态文本分析,也可用 Jev 等决策模型动态选择(示例称 Jev 支持最多 255 个选项,并通过 LangChain 的 TypeSafeClassifier 调用);当决策模型对首选 emoji 置信度低于 25% 时,会回退为默认的 👀。文章指出同一 emoji 在不同场景语义相反,建议用描述性文案而非图标名来匹配。该文为产品功能宣发,属于作者对设计思路的阐述,未附独立效果测评。

解读LangChain 将 agent 的过程可见性产品化为 Slack reactions API,本质是补上任务运行期与用户之间的反馈沟通层。文章属于官方功能介绍,没有用户研究或效果数据,不能据此判断这种 emoji UX 模式的实际价值。

预计阅读 2 分钟
09
豆包工作 模型/产品发布 IT之家

豆包工作新增画布功能,上线豆包2.1 Lite与Seedream 5.0 Flash图片模型

AI Summary豆包工作宣布任务模式新增画布功能:支持无限画布,用户可将素材、方案与创作成果集中排列,随时查看、对比和调整;生成内容后还能继续修改文字、配色与布局,以辅助复杂任务完成。同批上线的还有图片生成模型Seedream 5.0 Flash,以及轻量级豆包2.1 Lite模型,官方称后者“更省额度、更快交付”,多模态综合能力领先,适用于文档撰写、表格处理、PPT制作等高频办公场景。目前所列能力描述均出自官方介绍,暂无第三方验证数据。

解读豆包工作连续迭代,从目标/计划模式到画布和Lite模型,凸显字节用“轻量模型+界面交互”抢占办公Agent入口的思路。此次官宣缺少定价与实测数据,不应据此判定模型能力,后续要看额度和任务完成质量能否支撑高频场景。

预计阅读 70 秒
10
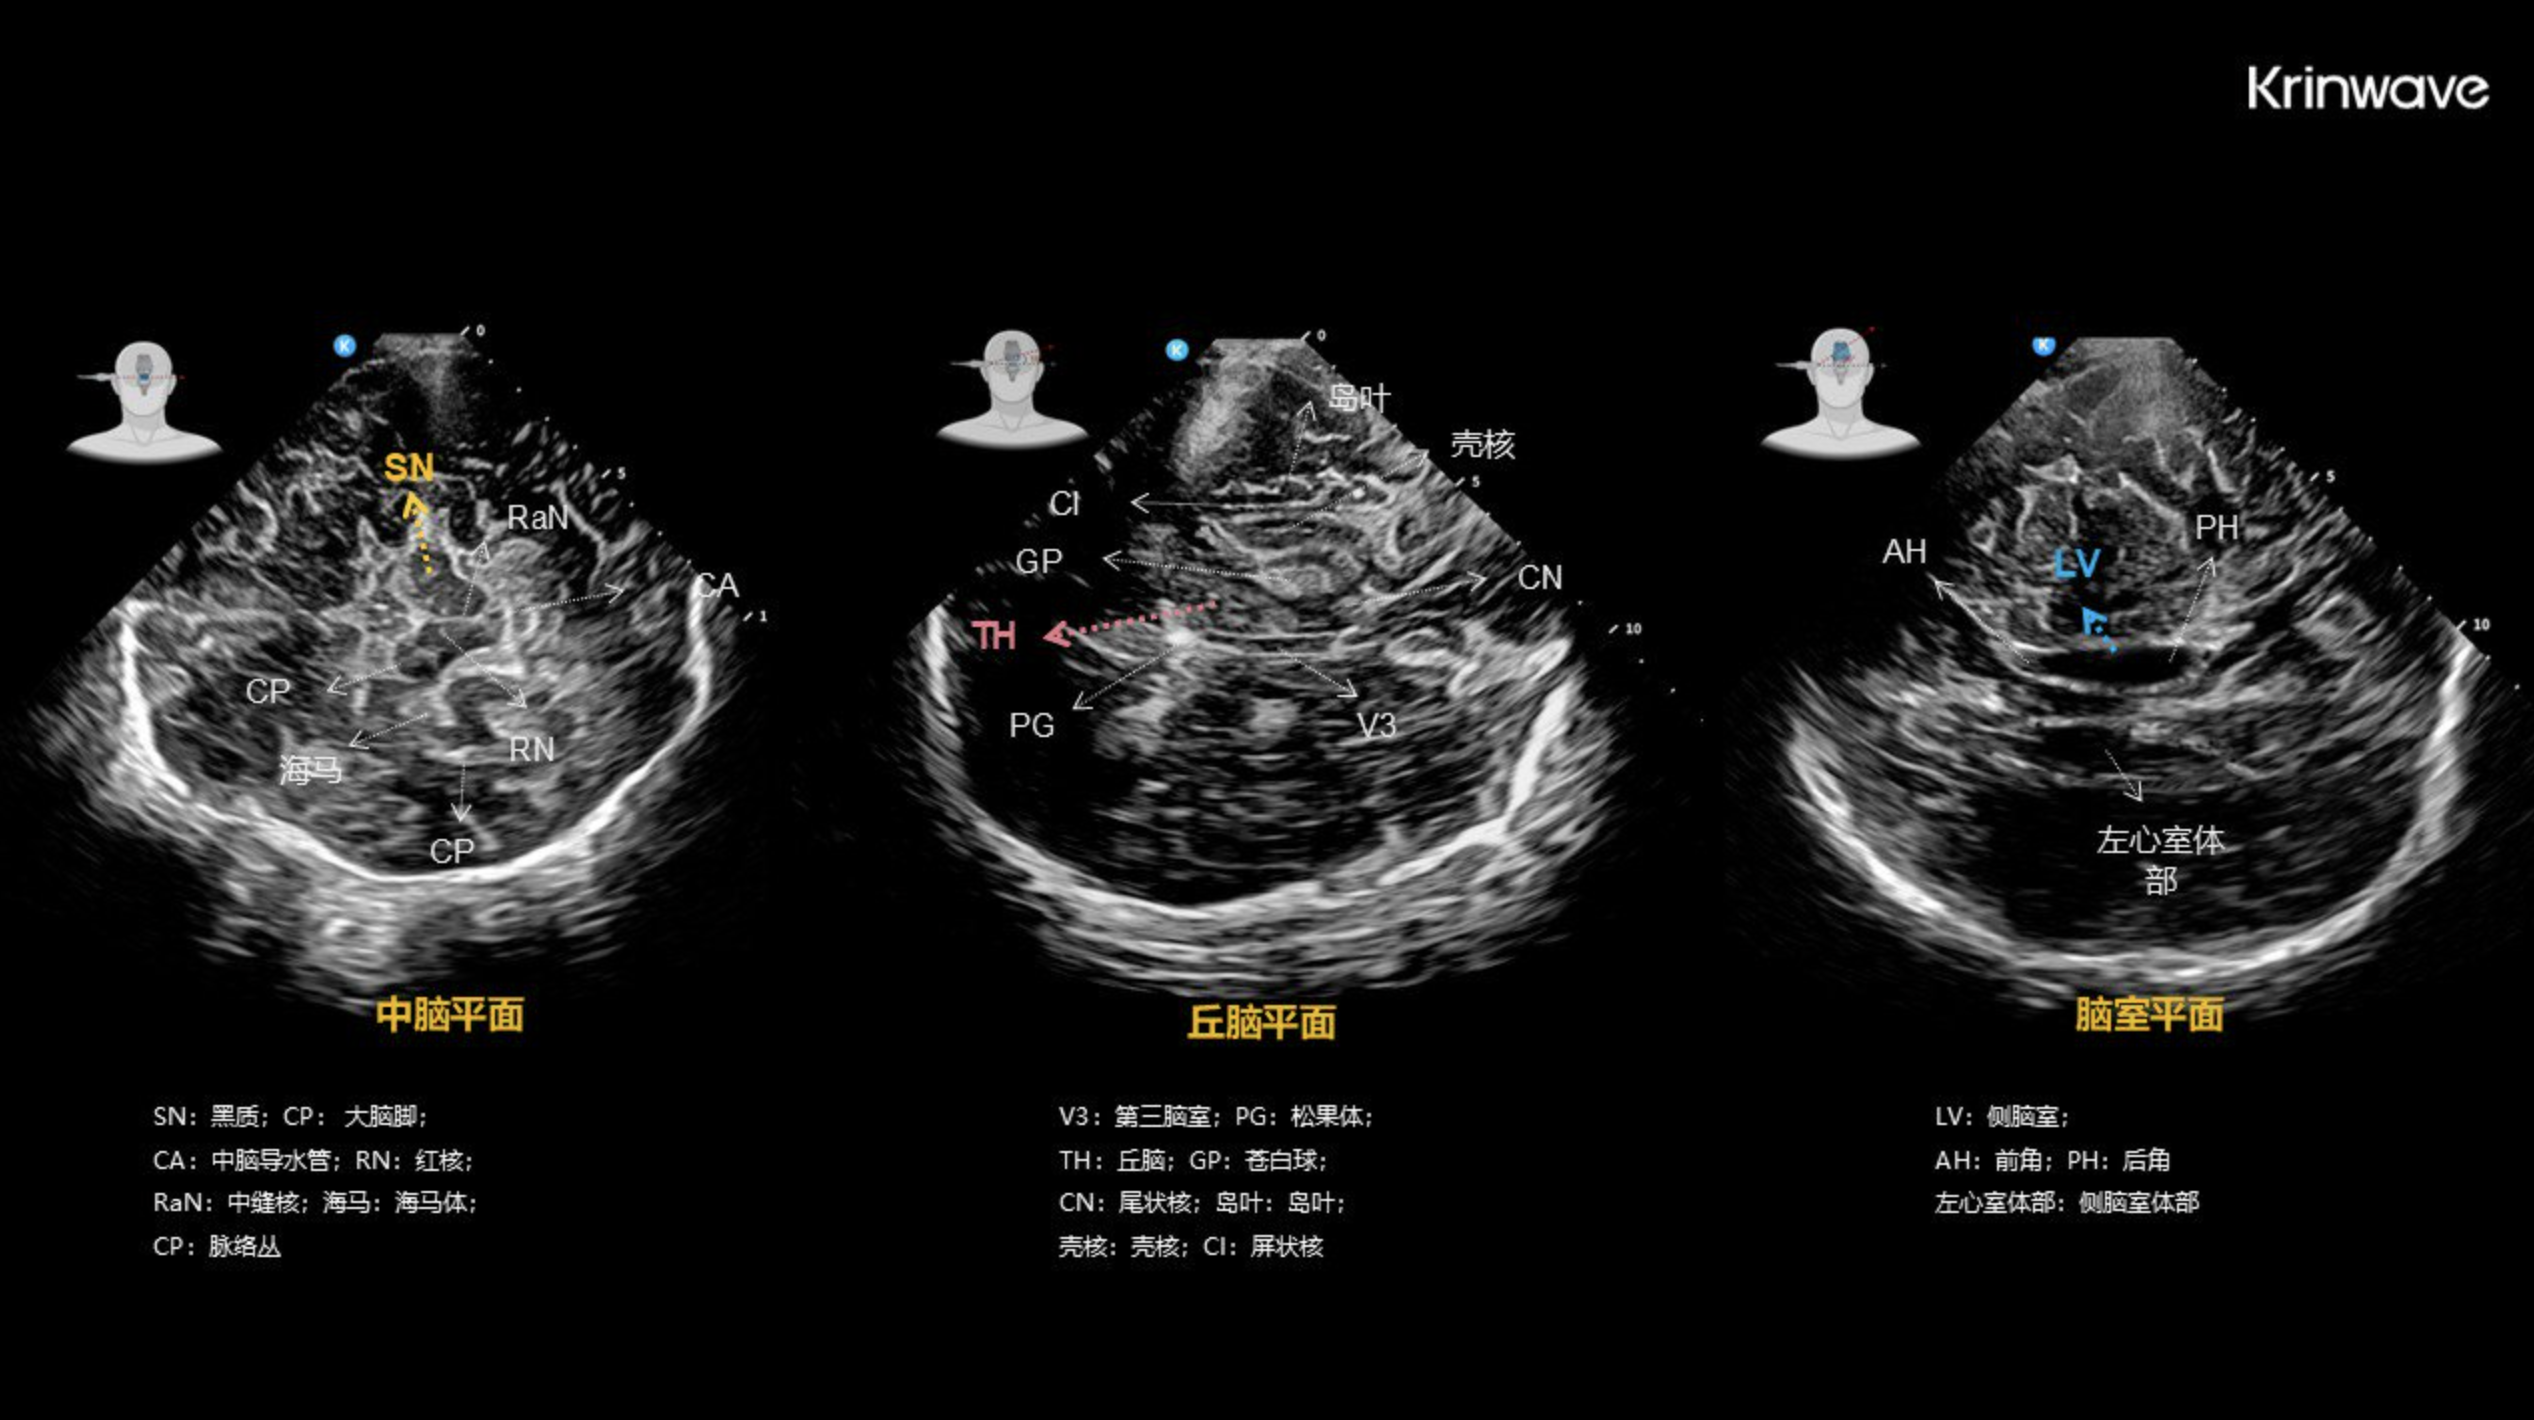
鲲为科技 融资/收购/估值 极客公园

鲲为科技完成4亿元融资,以低频超声+AI实现穿颅实时成像,目标做脑科学基础设施

AI Summary据极客公园报道,深圳鲲为科技近期完成4亿元新一轮融资,XVC、红杉中国为新进股东,老股东夏尔巴、腾讯加仓。核心技术弃高就低:以低频超声结合自研深度神经网络,处理每秒10GB回波数据,实时重建三维声学空间,在与海外旗舰彩超的颅骨侧面实测对比中能显示中脑核团、侧脑室及血流动态。公司称已获数千万元订单,规划以硬件+kOS平台做脑科学与AGI数据基础设施。

解读本质上是用低频+算力绕过传统超声“频率越高越清晰”的物理墙,把超声变成高带宽感知平台。真正决定估值叙事的不是融资额,而是穿颅成像能否通过医疗器械临床验证,以及kOS能否让脑机接口实验室长期接入。

预计阅读 65 秒
B

技术进展

Hugging Face · 技术报告 · 论文 · Benchmark · RL 研究

HF PAPERS

Hugging Face Papers 速读

查看当天论文

逐篇读取当天 paper 页面,由 deepseek-v4-flash-ga-260731 生成中文摘要。

01

AgentGarten:用于进化智能体的代码世界

AI Summary提出AgentGarten框架,耦合模拟器与神经渲染器构建实时交互环境,让智能体通过视觉探索学习,并利用Adversarial Forcing提升渲染质量与学习效率。

智能体训练神经渲染交互环境
05

SuperNav:任意任务与场景的智能体导航系统

AI Summary提出SuperNav,用预训练多模态大模型配合智能体导航框架,无需导航专用微调,即可在多种场景完成实例级、多目标等导航任务。

具身智能导航系统多模态大模型
01
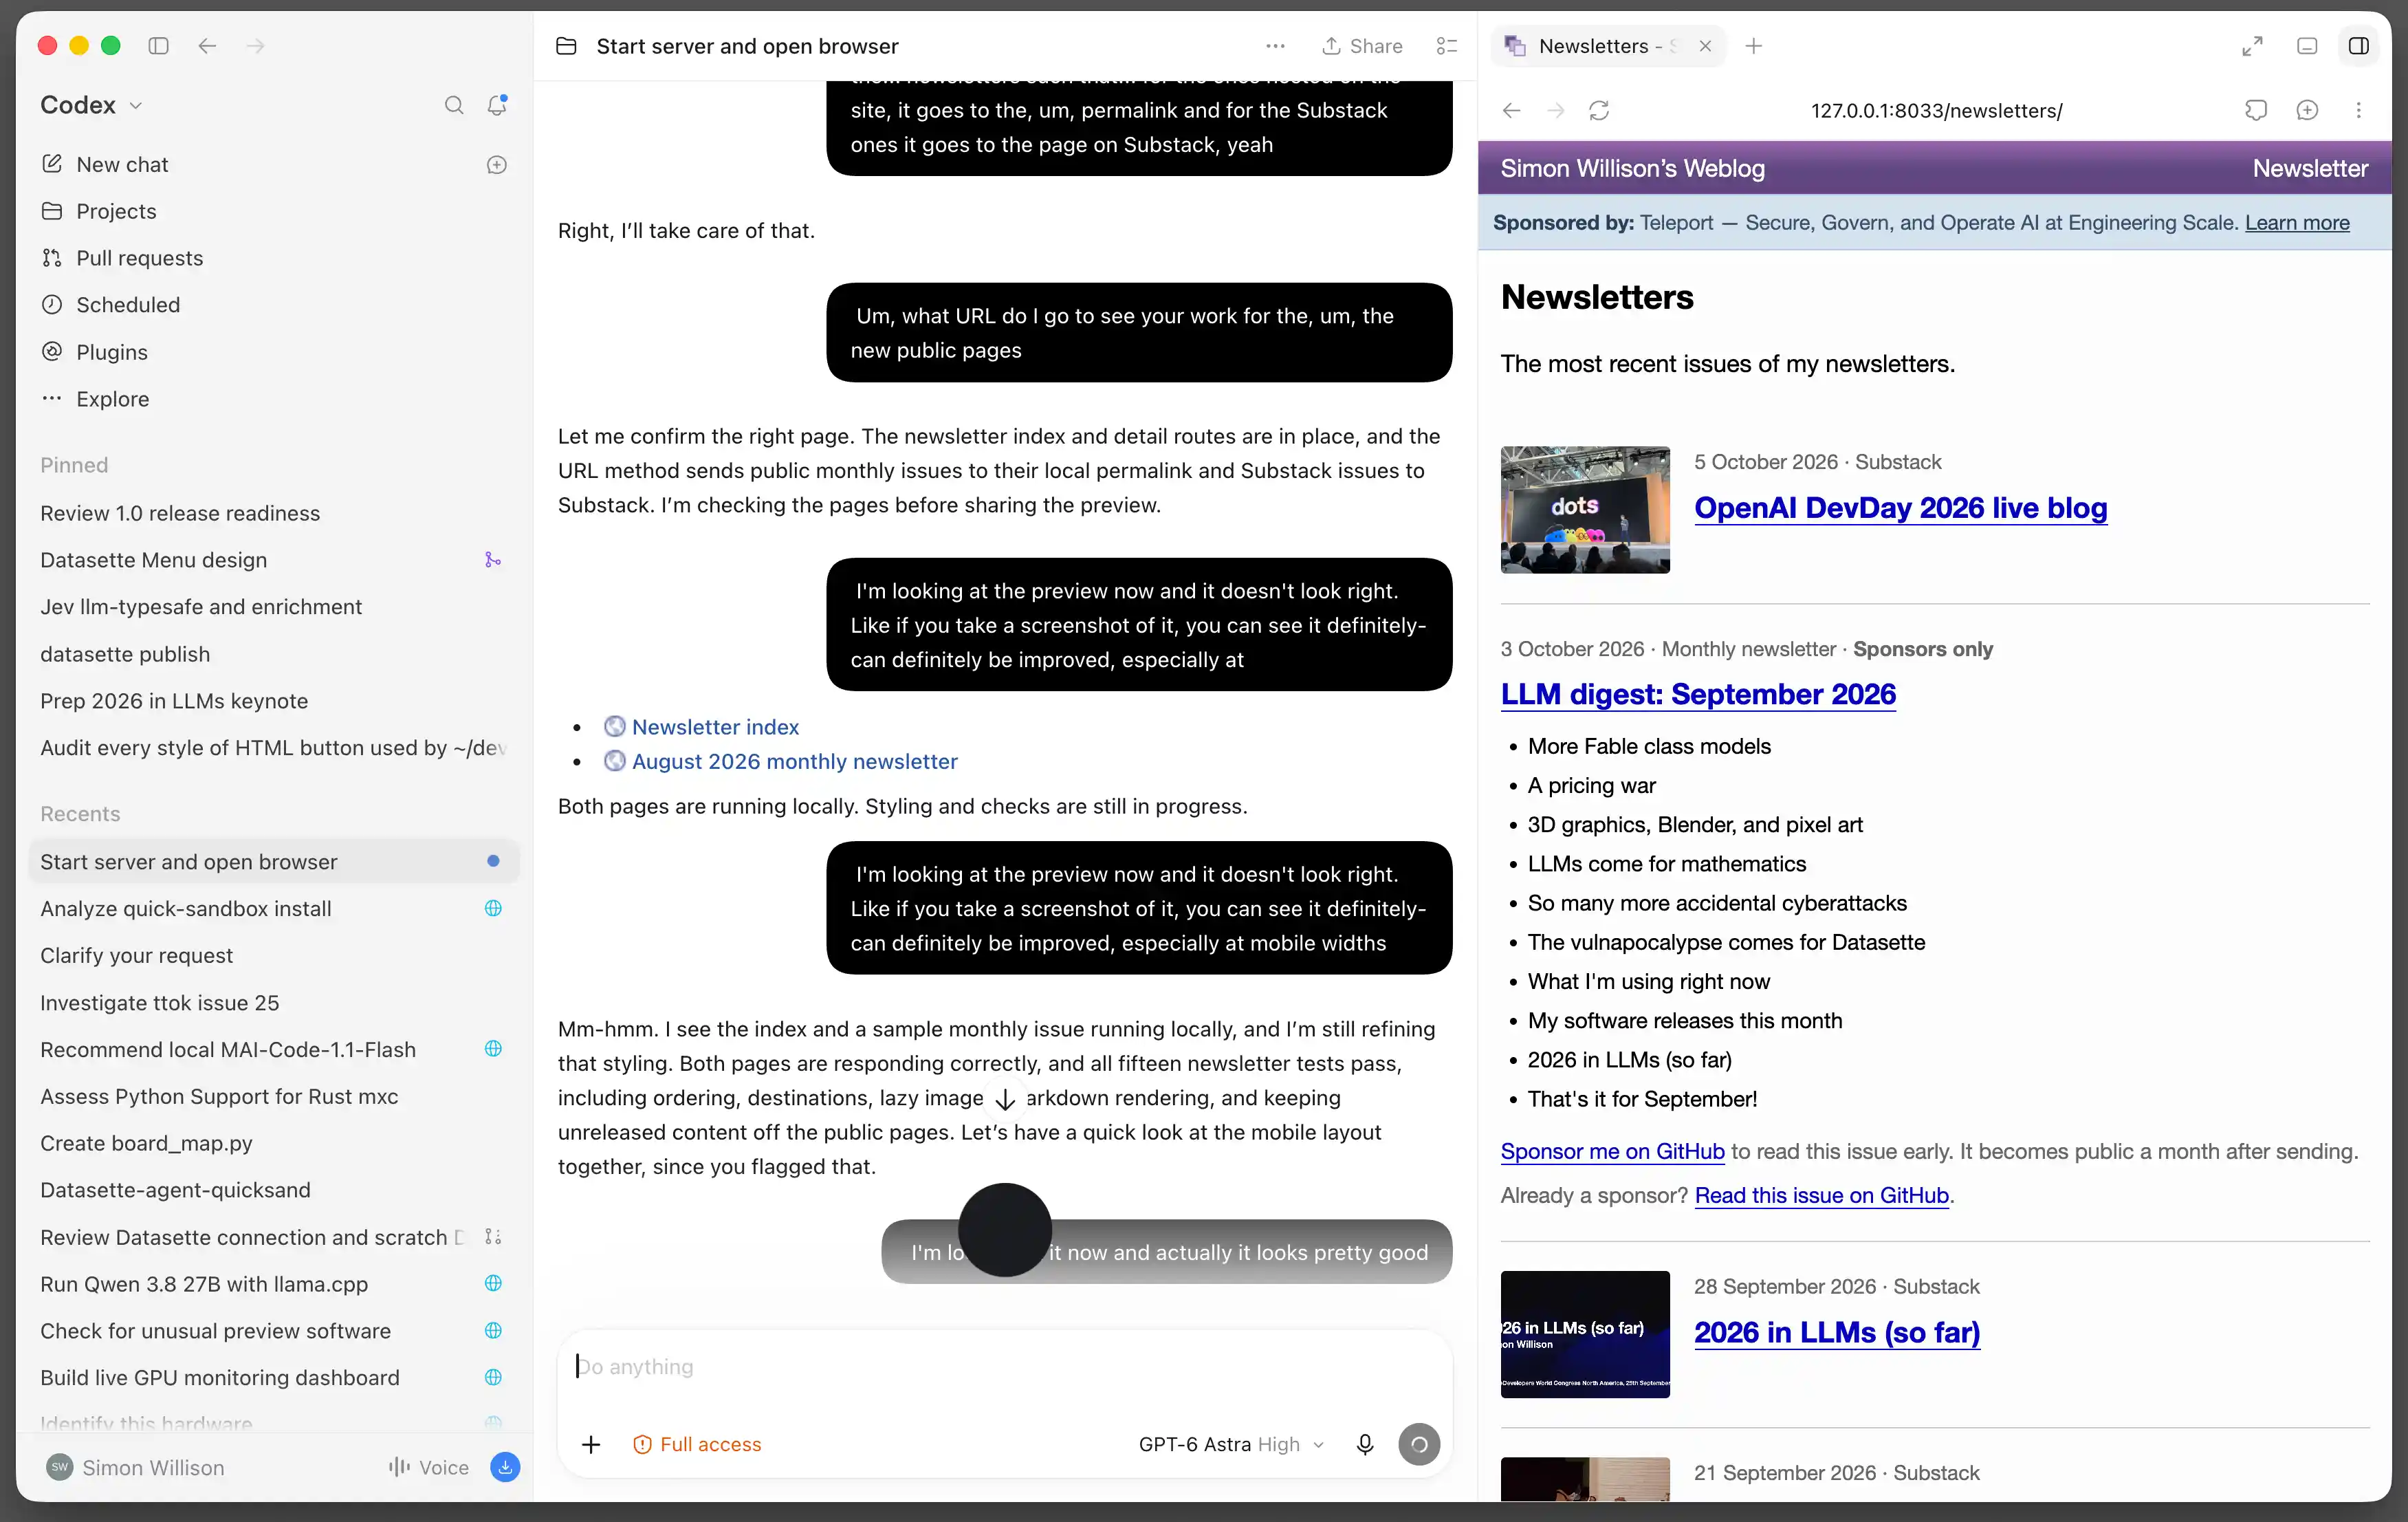
Simon Willison Agent/开发者基础设施 Simon Willison's Weblog

Simon Willison 用 Codex 语音模式开发博客 Newsletters 功能,GPT-6 Astra 半小时完成 Django 实现

AI SummarySimon Willison 用 Codex 语音模式为博客开发 Newsletters 索引页:在 ChatGPT 桌面端 Codex 标签启动语音对话,先打字启动本地 dev server,再边做饭边口述约半小时,由 GPT-6 Astra High 完成 Django 模型、迁移、视图、模板和 4 个导入逻辑,包括经 Substack 未公开 API(模型自试 /api/v1/archive 并检索分页方法)和私有 GitHub 仓库导入数据。随后 Codex 建分支开 PR,审查时作者发现某导入脚本用 Git subprocess,改为 API 方案,又花约半小时打字微调后部署。作者称语音加视觉预览是更强大的编码代理交互,但细节阶段打字粘贴仍更高效。

解读语音驱动开发能成立,靠的不是替代键盘,而是把 Agent 放进多任务场景:模型在需求含糊时能自主补齐细节,而人工审查和键入纠偏仍卡住关键路径。它更像工作流增强,而非通用编程方式的颠覆。

预计阅读 2 分钟
02
ttok Agent/开发者基础设施 Simon Willison's Weblog

ttok 1.0 发布:token 计数 CLI 默认改用 GPT-5/GPT-6 tokenizer

AI SummarySimon Willison 发布 token 计数/截断 CLI 工具 ttok 1.0,并将默认 tokenizer 从 GPT-4 切换为 GPT-5/GPT-6。此前他在升级 ttok 0.4 后发现默认值过时。OpenAI 尚未官方确认 GPT-6 与 GPT-5 家族共用 tokenizer;引用的 William Liu 实验显示,GPT-5.5、GPT-5.6 Sol/Terra/Luna、GPT-6 Astra/Sol/Luna 七个模型均在 31 个 fixture 上报告 44,794 tokens,结果一致,GPT-6 在该语料上不改变输入计数。

解读一个小工具的默认值切换,暴露了平台未定事项如何被下游生态提前消化:社区已在用实验替 OpenAI 确认 GPT-6 的 tokenizer 是否兼容,并在工程上做出选择。对依赖固定 token 计数的数据管道,这类默认变更比模型发布更直接影响成本与行为。

预计阅读 70 秒
03
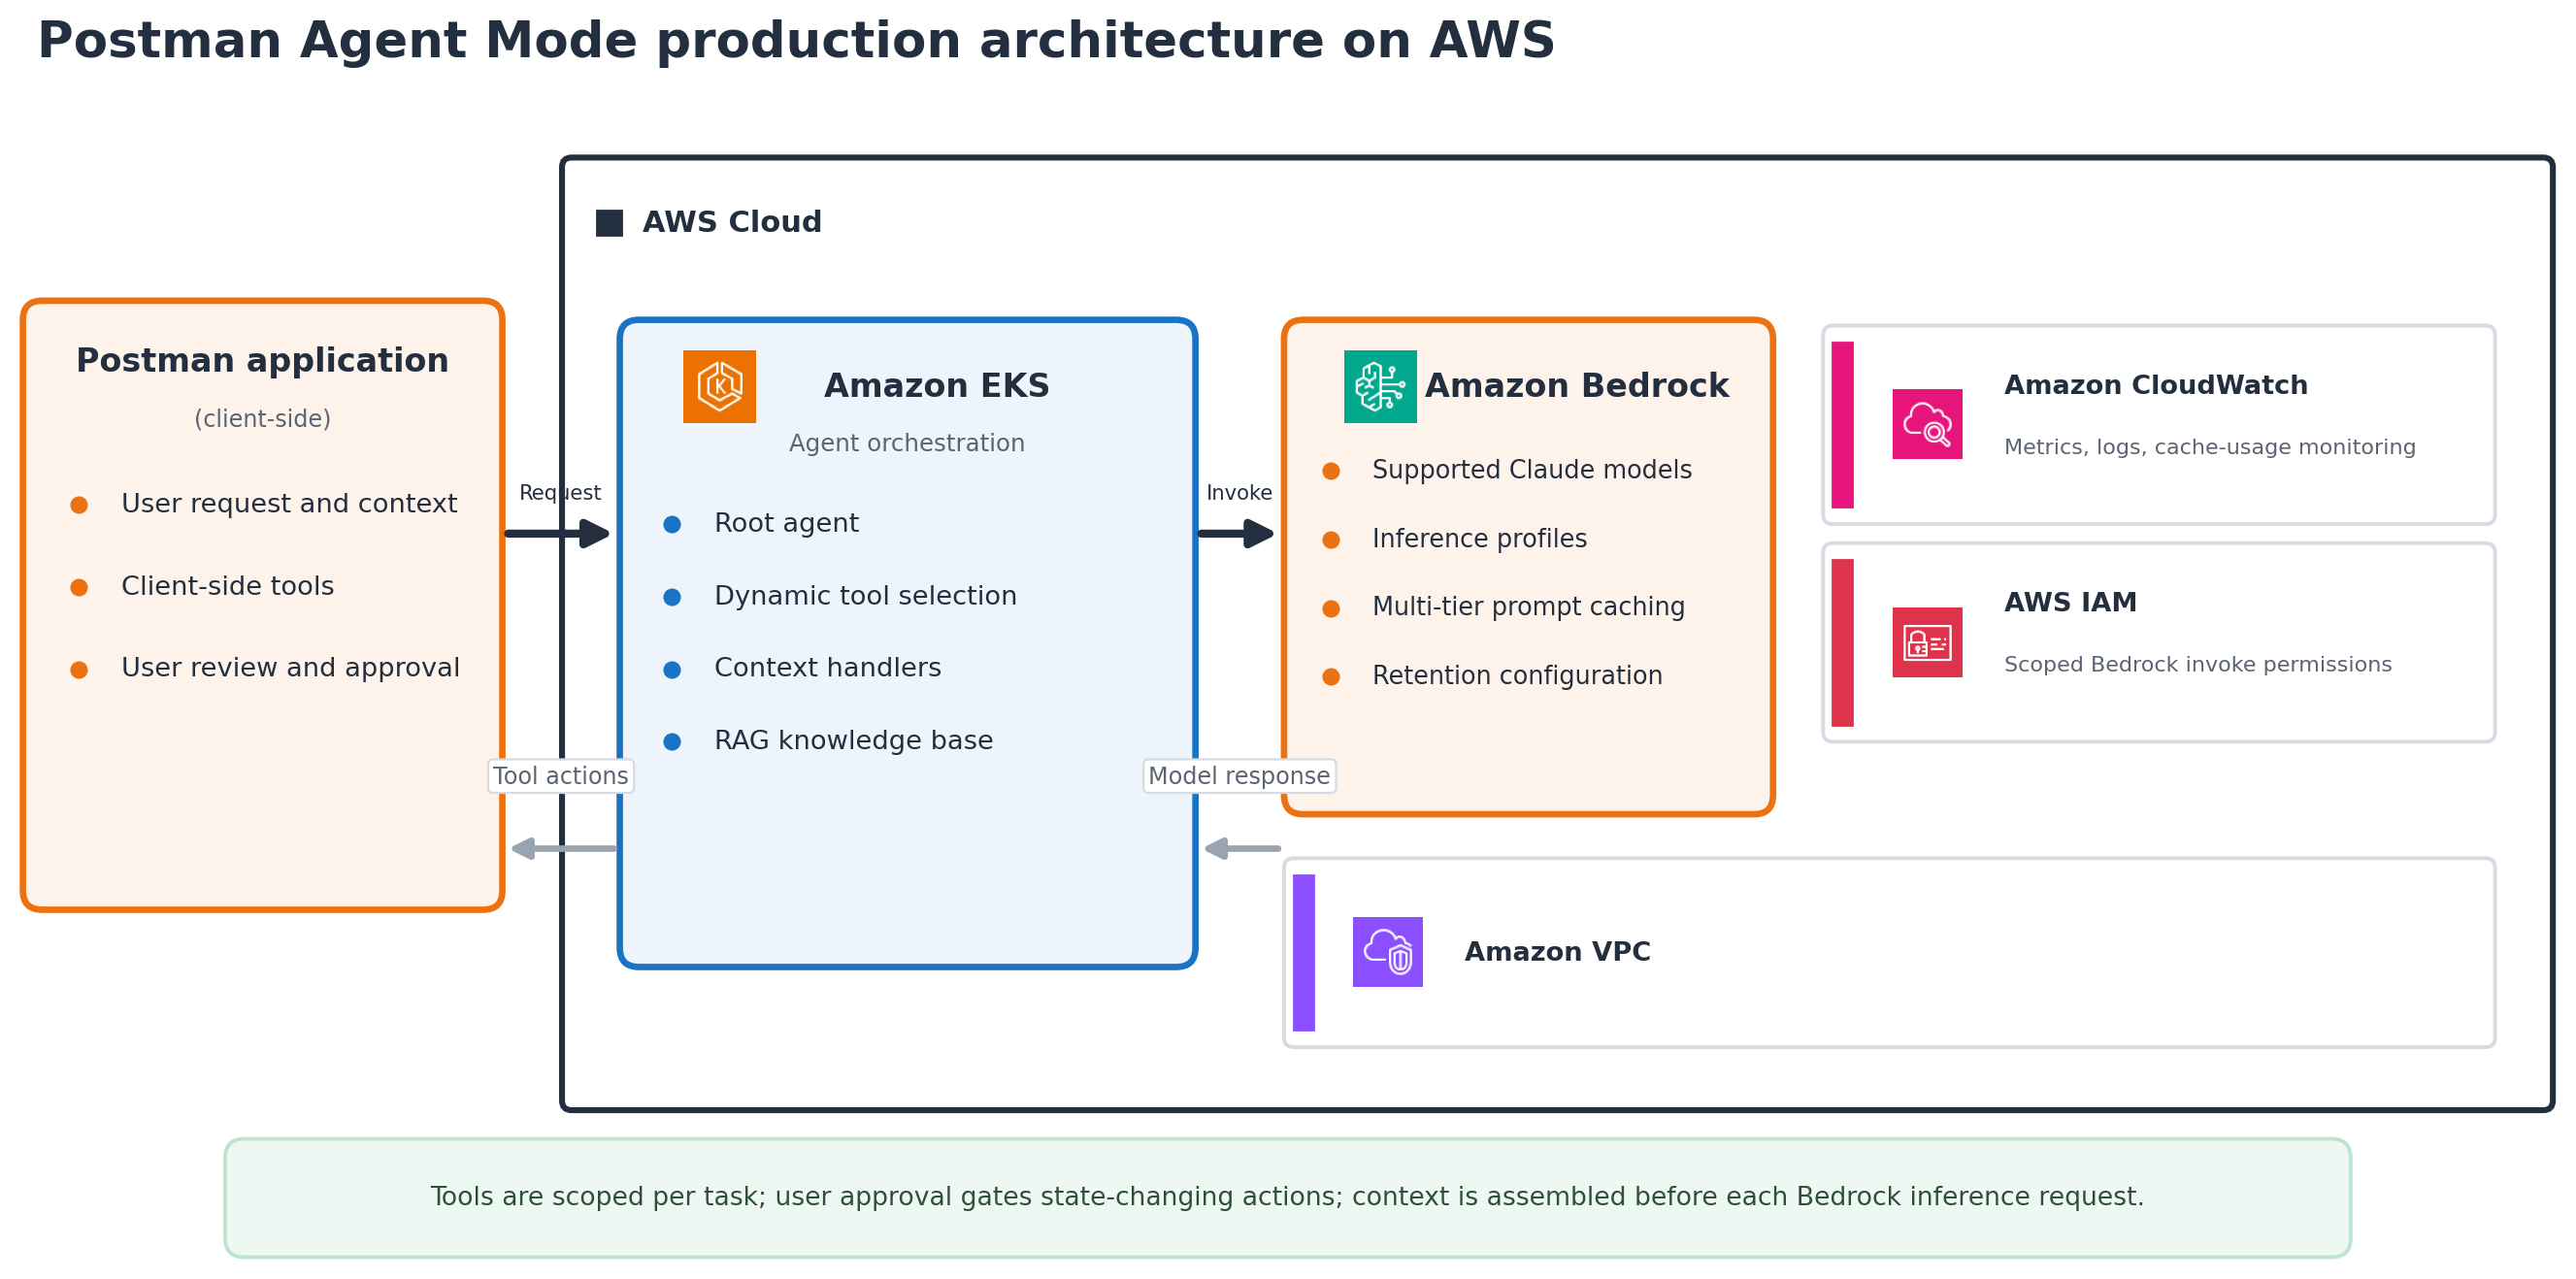
Postman Agent/开发者基础设施 AWS Machine Learning Blog

Postman 分享 Agent Mode 生产架构:基于 Bedrock 服务 4000 万开发者,170+ 工具裁剪至约 15 个

AI SummaryPostman 与 AWS 在官方博客拆解 Agent Mode 生产架构,该功能基于 Amazon Bedrock,面向 4000 万开发者。团队发现:瓶颈不在模型能力,而在工具与上下文治理——可见工具超过约 40 个后选择错误显著上升,因此通过向量库从 170 多个工具中动态选约 15 个交给上下文隔离的子 agent;API Catalog 改用基于 ClickHouse schema 的单一查询工具生成 SQL;同时用专用 context handler 管理上下文预算。Bedrock 侧采用 Claude 模型族路由、跨区域推理、按模型零保留和多层 prompt 缓存,Guardrails 在送入模型前编辑 PII;修改状态的操作仍需用户批准。

解读这篇合著博客把生产级 agent 的难点从模型能力转向工具与上下文治理:约 40 个工具是经验阈值,170+ 到 15 的动态裁剪是具体做法。报告由 AWS 发布,属于工程经验分享而非独立评测,但工具目录与上下文预算的思维值得参考。

预计阅读 2 分钟
04
Databricks Agent/开发者基础设施 Databricks Blog

Databricks Lakebase 用数据库分支支撑 Agentic SDLC:copy-on-write 秒级建库,每个 agent/PR 一个隔离库

AI SummaryDatabricks 官方博客介绍 Lakebase Postgres 数据库分支能力,面向多个编码智能体并行开发时的数据隔离。其采用 copy-on-write,据称分支创建在 1 秒内完成、与库大小无关,空闲分支可缩容至零、不产生计算成本。文章给出端到端工作流:Git worktree 加 Claude Code hook 为每个 agent 自动建分支,GitHub Actions 为每个 PR 生成临时分支,运行 Drizzle 迁移、在 Databricks Apps 部署预览并回贴 schema diff。分支不合并回主库,schema 变更经迁移工具随代码推广;另列出 bug 复现、迁移验证、Unity Catalog 脱敏等场景。

解读数据库是多智能体并行开发常被忽视的瓶颈:共享库导致 schema 冲突、测试互相干扰。Databricks 用 copy-on-write 分支把数据库变成秒级创建、可休眠的隔离资源,配合 Git worktree 形成"一个 agent 一个库"的范式。这是厂商自述的工程方案,分支不合并回主库,一致性靠迁移链保障。

预计阅读 2 分钟
05
NVIDIA Agent/开发者基础设施 NVIDIA Blog

NVIDIA 博客演示 AI Agents 结合 Omniverse 构建仿真:七个案例含 Robo Olympics 跨栏 64/100

AI SummaryNVIDIA 官方博客展示开发者用前沿 AI 模型(GPT-6 Astra、Claude Fable 5)与 Omniverse 库构建仿真应用的七个案例。机制上,开发者以自然语言指令驱动 Agent 调用 GPU 加速物理(ovphysx)、渲染(ovrtx)、场景与 UI 库,并逐段检查集成。案例包括:Astra 将仓库人形机器人变为交互模拟器;基于旧金山 Market Street 构建自动驾驶测试环境 Zero to Alpamayo;用 Agent 对比虚拟/真实相机与 LiDAR 输出来改进数字孪生;指导 Astra 构建 Robo Olympics,Unitree G1 跨栏在 100 次仿真中成功 64 次;在 Onshape/Isaac Sim 中设计工具完成汽车悬挂拆卸;单提示词组装国际空间站 OpenUSD 模型并流式传输到浏览器;将立体相机捕捉转为可编辑 OpenUSD 工作室。均为 NVIDIA 员工演示,无独立测评。

解读这是 NVIDIA 对 Omniverse + Agent 工作流的生态展演,证明的不是模型智商,而是自然语言编排与 GPU 物理/渲染库的可组合性。64/100 的跨栏成功率只是单个演示指标,不能外推为通用机器人能力。

预计阅读 2 分钟
C

行业观点

X 大 V · YouTube / Podcast · Builder 观察 · 开发者讨论

今天没有足够明确的入选事件,先空着。