基础模型与技术
AI DAILY BRIEF · EVENT NOTES · 2026.07.11
for AI era builders
EDITORIAL BRIEF
AI 行业简报 2026-07-11
今天筛出 15 个事件:大厂动态 5 条,技术进展 3 条,行业观点 7 条;另读 Hugging Face Papers 5 篇。
TOP 3 · 今日重点
先读重要变化,再看技术细节基础模型与技术
Anthropic:Working at the frontier: How Cognition trusts Claude Fable 5 to work through the night
阅读解读与来源 →AI 产品与工具
Meta:Meta turns off the Instagram feature that let users make AI deepfakes of public accounts
阅读解读与来源 →按主题查阅 15 个事件
基础模型与技术2
行业 / 商业动态0
本期暂无达到入选标准的新内容
AI 产品与工具2
Agent 技术2
工程实践2
AI + 行业赋能0
本期暂无达到入选标准的新内容
算力硬件与基础设施0
本期暂无达到入选标准的新内容
政策、安全与社会影响0
本期暂无达到入选标准的新内容
人才与组织0
本期暂无达到入选标准的新内容
A
大厂动态
AI 公司动态 · 模型发布 · 新业务 · 融资投资 · 人员变动
OpenAI:To celebrate the launch of GPT-5.6 Sol, we will reset the rate limits again (twice) across ChatGPT Work and Codex over the next 24 hours.
事实摘要
OpenAI 为庆祝 GPT-5.6 Sol 发布,将在 24 小时内两次重置 ChatGPT Work 和 Codex 的速率限制,鼓励用户尝试复杂任务。
编辑解读
临时放宽速率限制是营销手段,旨在推动用户迁移至新模型,而非基础设施或能力升级。
预计阅读 35 秒
Anthropic:Working at the frontier: How Cognition trusts Claude Fable 5 to work through the night
事实摘要
Cognition的SVP Silas Alberti表示,Claude Fable 5是首个能信任整夜运行的模型,在长时间任务中保持清晰,基准测试得分从10%提升至30%。
编辑解读
模型能力提升的关键在于长时间任务中的稳定性和自我纠错能力,而非单点基准测试。
预计阅读 30 秒

Meta:Meta turns off the Instagram feature that let users make AI deepfakes of public accounts
事实摘要
Meta 因公众强烈反对,关闭了本周刚推出的 Instagram 功能,该功能允许用户通过 @ 提及公共账户来生成 AI 图像。
编辑解读
Meta 因公众反对迅速撤回有争议的 AI 图像生成功能,暴露了产品设计中对用户肖像权和滥用风险的忽视。
预计阅读 30 秒
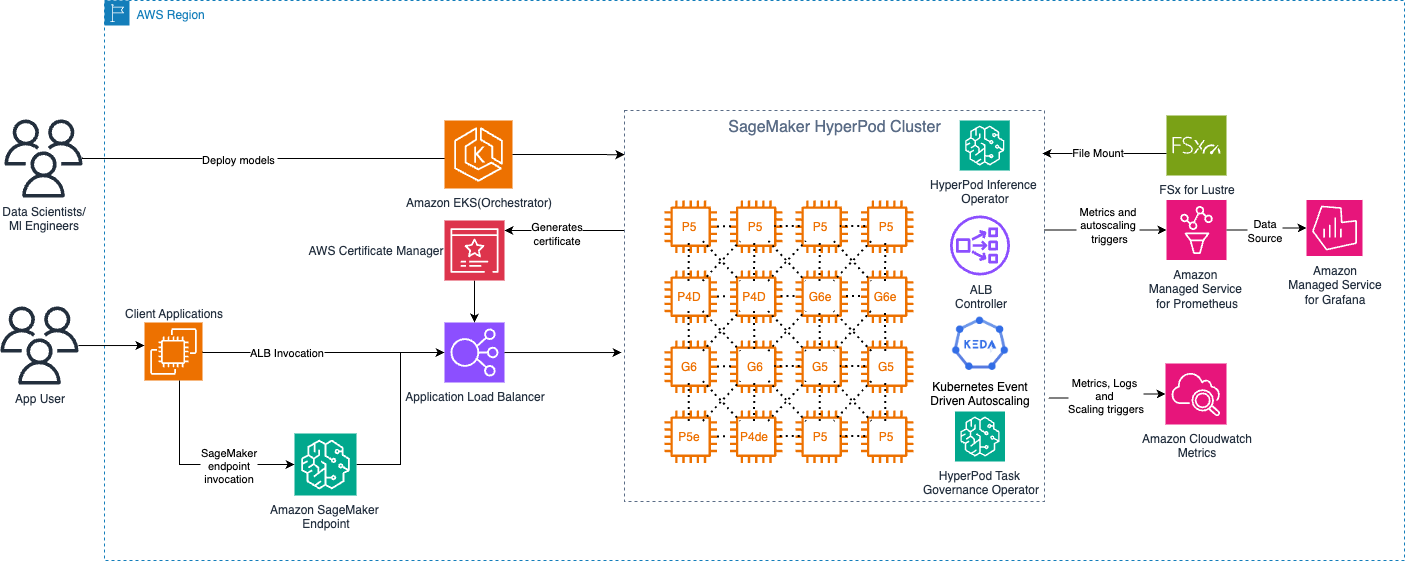
Amazon SageMaker HyperPod:Enhancing enterprise inference on Amazon SageMaker HyperPod with data capture, Hugging Face, NVMe, and Route 53 integration
事实摘要
AWS 为 SageMaker HyperPod 推理新增五项企业级能力:多层数据捕获、Hugging Face 直接部署、NVMe 本地加载、Route 53 DNS 管理和 pod 级 IAM。
编辑解读
AWS 在推理基础设施上补齐可观测性、安全性和部署灵活性,降低冷启动延迟。
预计阅读 35 秒

Anthropic:桌面版 Claude Code 新增应用内浏览器,可用于 AI 调试网页等
事实摘要
Anthropic 为桌面版 Claude Code 新增内置浏览器,支持读取、点击并与网站交互,用于构建和测试应用,浏览器配置与用户个人浏览器隔离。
编辑解读
Claude Code 从纯代码工具向带浏览器调试的 Agent 环境演进,但浏览器功能仍限于无需登录的页面。
预计阅读 30 秒
B
技术进展
Hugging Face · 技术报告 · 论文 · Benchmark · RL 研究
HF PAPERS
查看当天论文
Hugging Face Papers 速读
逐篇读取当天 paper 页面,由 deepseek-v4-flash-260425 生成中文摘要。

重新思考视频理解评估:Video-Oasis诊断套件揭示基准漏洞
研究摘要
提出Video-Oasis诊断套件,发现55%视频基准样本无需视觉或时间信息即可解答,过滤后模型性能仅略高于随机。
视频理解基准评估Video-LLM


UniClawBench:面向真实世界任务的主动智能体通用基准
研究摘要
提出首个基于能力的基准,用于评估主动智能体在动态真实环境中的表现,包含400个双语任务和闭环评估策略。
基准测试主动智能体多模态


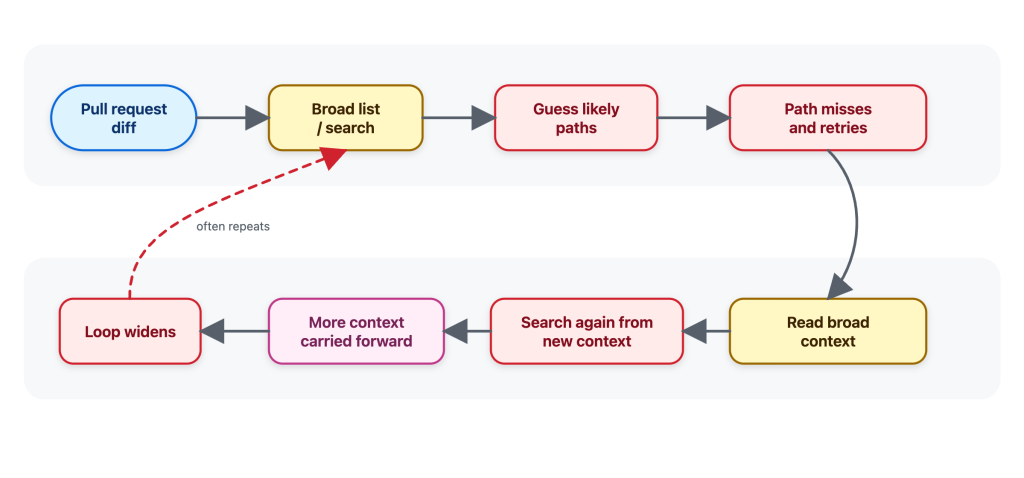
GitHub:Better tools made Copilot code review worse. Here’s how we actually improved it.
事实摘要
GitHub 博客介绍如何将 Copilot 代码审查迁移到共享的 Unix 风格代码探索工具,通过重塑 agent 工作流来降低审查成本。
编辑解读
核心改进不是换工具,而是让 agent 围绕 PR 证据重新组织工作流,减少无效探索。
预计阅读 30 秒
Google DeepMind:A Reliability Assessment of LALM Audio Judges for Full-Duplex Voice Agents
事实摘要
Google DeepMind 评估 Gemini 模型作为全双工语音代理的音频评判者可靠性,在 209 个立体声会话上对比人类评分,发现 Gemini 2.5 Flash 在多数维度与人类一致,成本低两个数量级。
编辑解读
用 LLM 替代人工评估语音代理质量可行,但模型切换需重新校准,不能仅依赖排序相关性。
预计阅读 35 秒
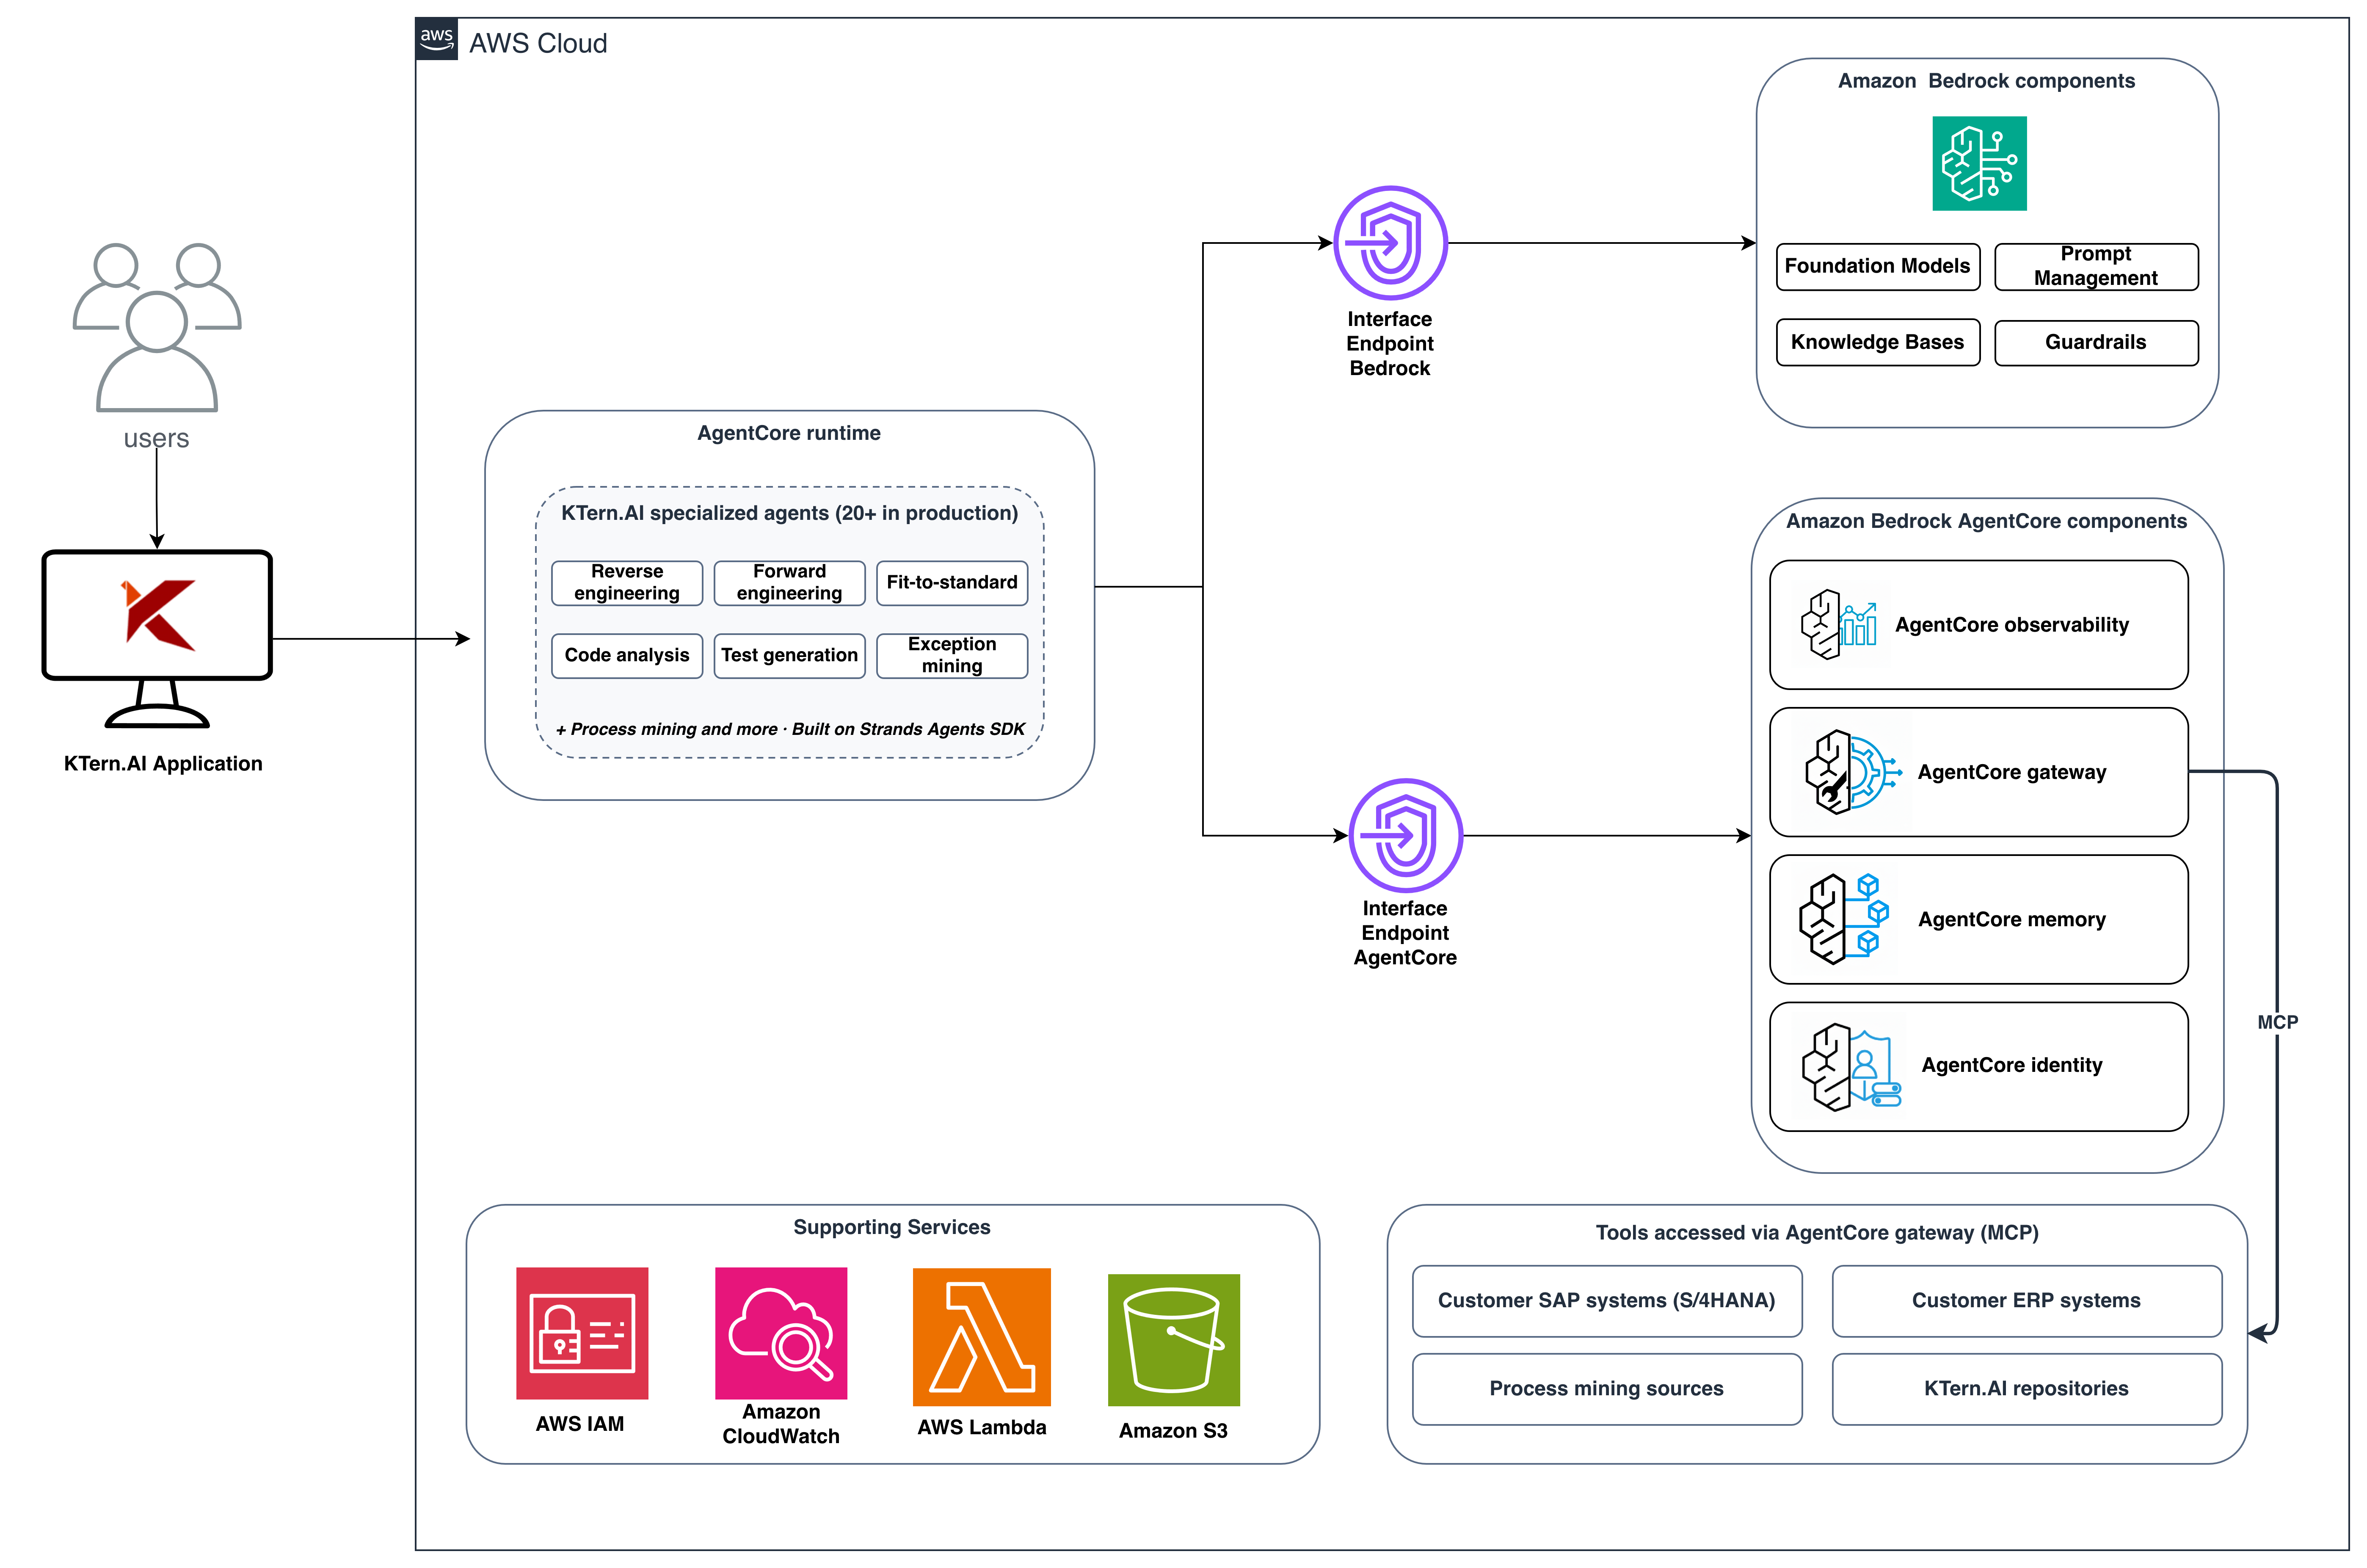
KTern.AI:How KTern.AI built agentic AI for SAP on Amazon Bedrock AgentCore
事实摘要
KTern.AI 在 Amazon Bedrock AgentCore 上构建了面向 SAP 数字化转型的多智能体系统,实现配置驱动部署,将项目周期缩短 45%。
编辑解读
企业级 agent 落地的关键不是模型能力,而是持久上下文、安全工具集成和可观测性基础设施。
预计阅读 25 秒
C
行业观点
X 大 V · YouTube / Podcast · Builder 观察 · 开发者讨论

DataBricks:According to DataBricks, pi-coding-agent is ~2x cheaper than CC/Codex, GLM 5.2 on par with Opus 4.8 high
事实摘要
DataBricks 声称 pi-coding-agent 比 CC/Codex 便宜约 2 倍,且 GLM 5.2 与 Opus 4.8 high 性能相当。
编辑解读
单一成本或性能对比缺乏完整上下文,需关注测试方法和任务分布。
预计阅读 25 秒

MiniMax:MiniMax,替整个AI行业挨打
事实摘要
MiniMax上市后首轮解禁股价暴跌24%,随后宣布160亿港元融资。文章分析其M3模型定价失误、产品整改等问题,并指出资本市场对AI公司估值逻辑已从模型竞争转向公司竞争。
编辑解读
MiniMax成为首家被二级市场用上市公司标准审判的大模型公司,暴露了技术信仰与商业变现之间的鸿沟。
预计阅读 30 秒