AI DAILY BRIEF · EVENT NOTES · 2026.10.06 for AI era builders

EDITORIAL BRIEF

AI 行业简报 2026-10-06

今天筛出 11 个事件:大厂动态 5 条,技术进展 4 条,行业观点 2 条;另读 Hugging Face Papers 5 篇。

A

大厂动态

AI 公司动态 · 模型发布 · 新业务 · 融资投资 · 人员变动

01
Cresta Agent/开发者基础设施 Claude Blog

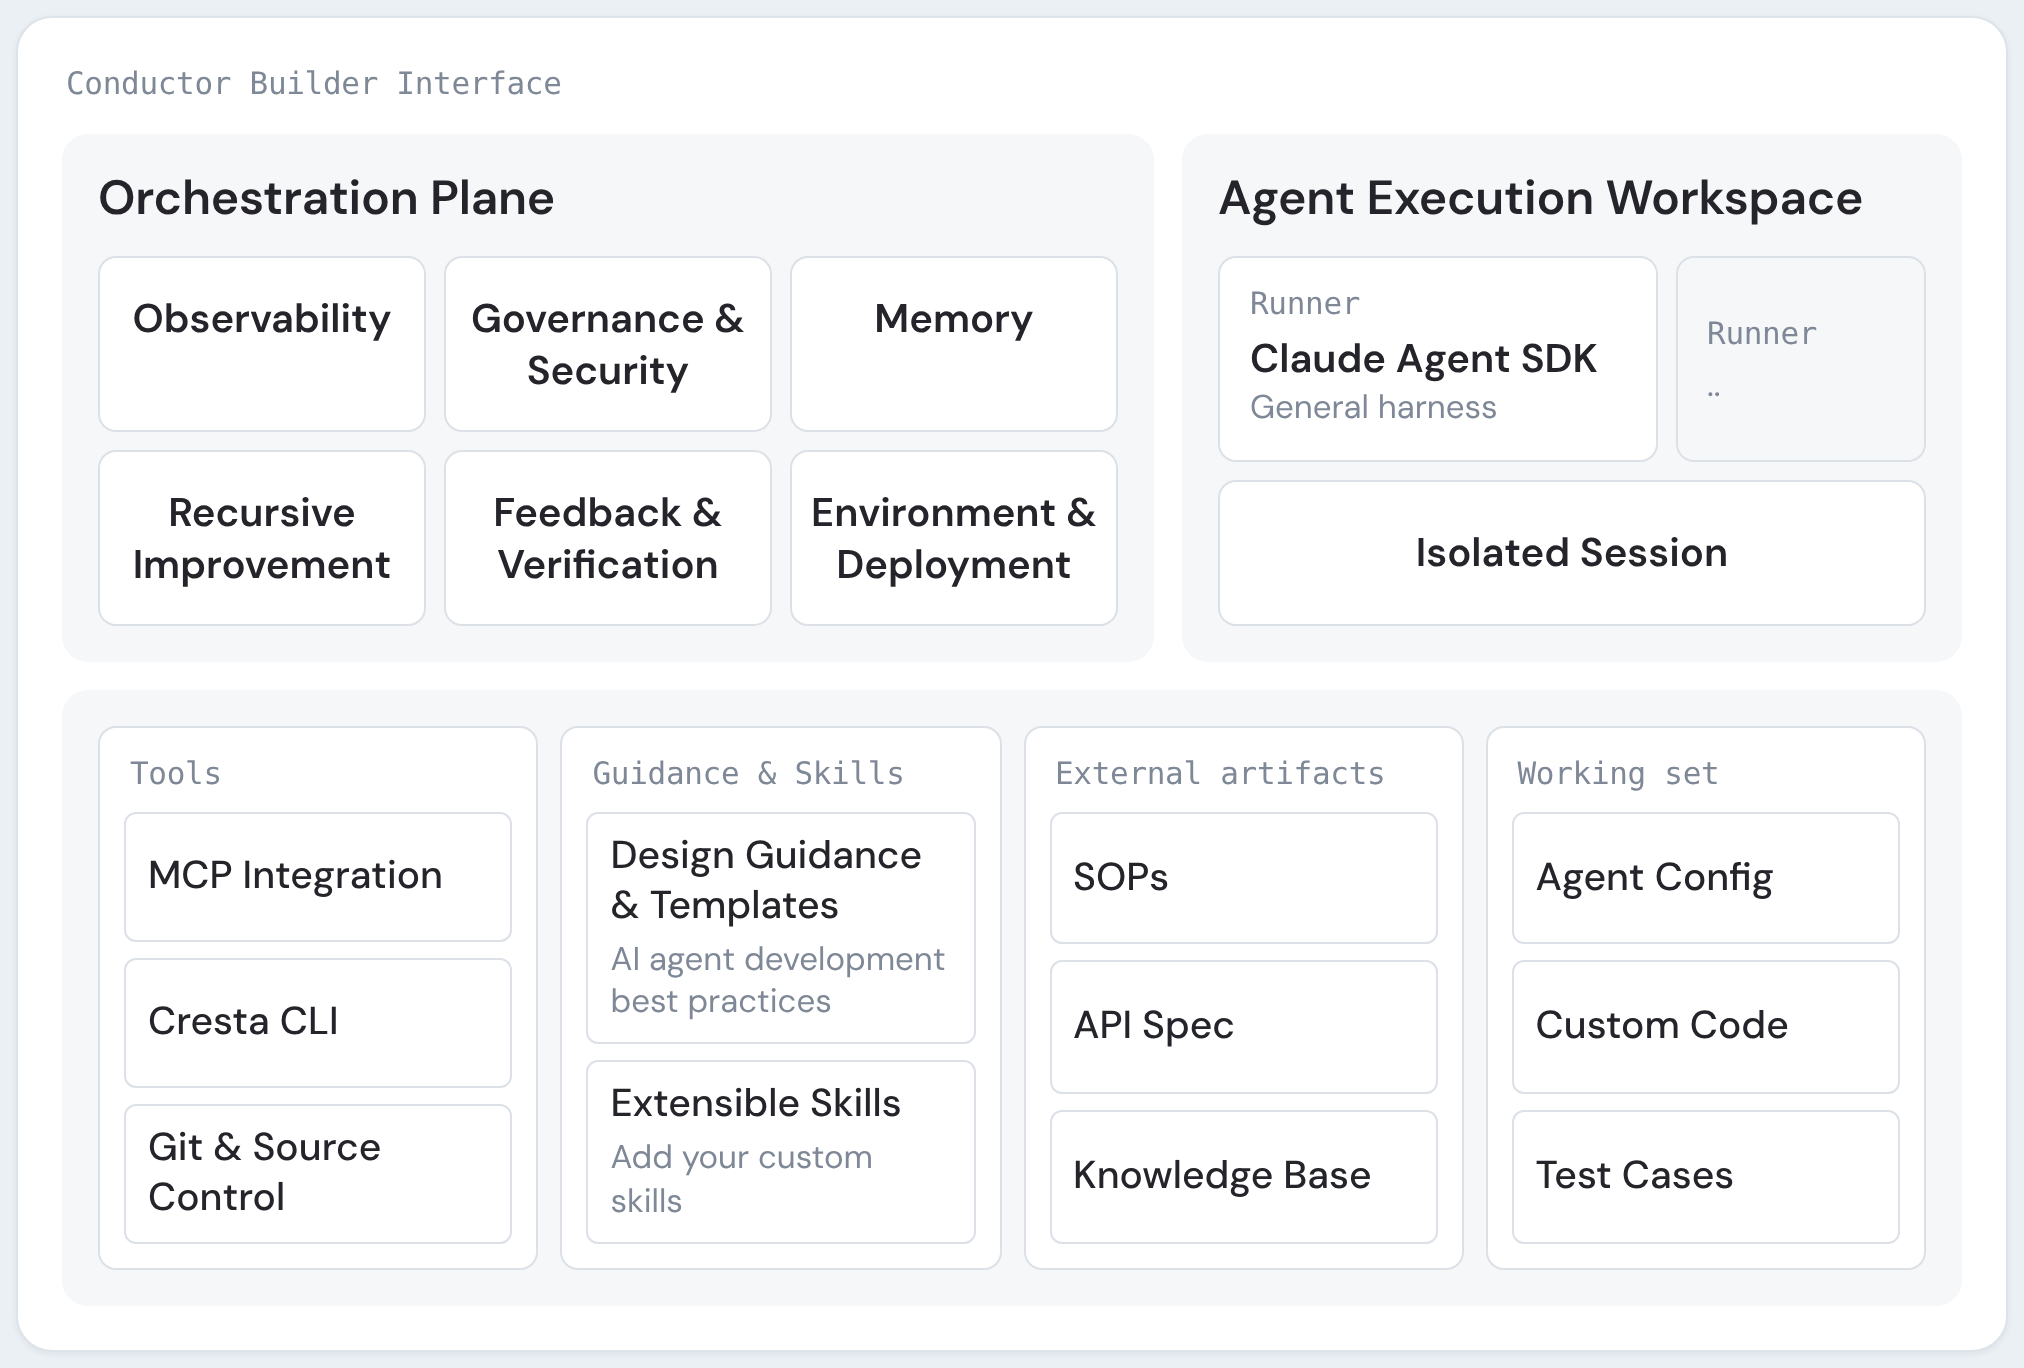
Cresta:How Cresta turned CX expertise into an agent builder on the Claude Agent SDK

AI SummaryCresta基于Claude Agent SDK构建Conductor,一个自然语言agent构建器,可生成、评估和优化客服agent,称可将初期部署时间缩短约一半。

解读本质是Anthropic官方博客的生态案例,核心是“用agent造agent”;部署时间减半来自Cresta自述,需独立验证。

预计阅读 30 秒
02
OpenAI 模型/产品发布 The Verge AI

OpenAI:OpenAI is adding text watermarking in ChatGPT and Codex

AI SummaryOpenAI将在欧盟向ChatGPT和Codex用户推出基于textGrain的不可见文本水印,非全球默认;API客户可选择启用,并有条件向研究人员开放检测器。

解读这更多是EU AI Act合规动作,而非能力升级;OpenAI也承认水印检测不保证可靠,且不公开检测器,实际约束有限。

预计阅读 30 秒
03
OpenAI 监管/安全/隐私 TechCrunch AI

OpenAI:OpenAI will start watermarking ChatGPT’s text in the EU

AI SummaryOpenAI 宣布为遵守欧盟 AI 法案,未来几周将对欧盟区 ChatGPT 与 Codex 生成文本添加不可见水印,同时发布技术报告 textGrain;检测器限研究机构使用,编辑可显著降低检测率。

解读水印是通过扰动词选择嵌入的合规痕迹,编辑即可绕过;OpenAI 仅限欧盟且默认关闭,显示合规与用户留存之间仍在妥协。

预计阅读 35 秒
04
AWS Agent/开发者基础设施 AWS Machine Learning Blog

AWS:New agent skill: Amazon SageMaker optimized generative AI inference for your coding agent

AI SummaryAWS 为 SageMaker 推理发布 aws-ai-ml skill,编码 agent 通过 Agent Toolkit 安装后可自动生成代码,完成端点基准测试、实例推荐与性能对比。

解读本质是把推理优化经验固化成 agent 技能,产出可读可跑的代码,目标是让工具链与生态绑定在 SageMaker 上。

预计阅读 30 秒
05
Google DeepMind 模型/产品发布 IT之家

Google DeepMind:谷歌有望升级 Call for Me 功能:Gemini 将支持代用户拨打私人亲友电话

AI SummaryIT之家援引Android Authority的发现称,谷歌“代我通话”功能可能从商户通话扩展至亲友私人电话,由Gemini转达信息或简单问询,并允许用户拒接AI来电,但该功能仍在开发,上线时间未定。

解读把AI通话从工具场景拓展到社交场景,仍是受限任务的试探,关键在权限与拒接设计。

预计阅读 35 秒
B

技术进展

Hugging Face · 技术报告 · 论文 · Benchmark · RL 研究

HF PAPERS

Hugging Face Papers 速读

查看当天论文

逐篇读取当天 paper 页面,由 deepseek-v4-flash-ga-260731 生成中文摘要。

05

多终止位置任务设置结果比较

AI Summary根据有限的摘要,论文比较了多个终止位置任务场景下的实验结果,具体内容待确认。

任务设置终止条件结果比较
01
llama.cpp 模型/产品发布 Reddit r/LocalLLaMA

llama.cpp:llama.cpp v0.6.0 released with MTP speculative decoding for Qwen4Exp and lots more

AI Summaryllama.cpp 发布 v0.6.0,为 Qwen4Exp 加入 MTP 投机解码支持,并包含多项其他更新。消息来自 Reddit 帖子,完整改动清单尚未见于公开信息。

解读开源推理引擎对新模型的适配越来越快,投机解码正成为本地推理默认优化方向。但单一版本更新的实质收益还要看官方基准。

预计阅读 30 秒
02
智谱 研究/Benchmark Reddit r/LocalLLaMA

智谱:A benchmark for LLMs playing Civilization V. GLM-5.3 is ahead of Opus-5.5, and Qwen-3.8-27B holds up surprisingly well.

AI SummaryReddit用户发布了一套测试LLM玩《文明V》的基准,结果显示GLM-5.3领先于Opus-5.5,而体积更小的Qwen-3.8-27B表现意外出色。

解读单一游戏基准的偶然性很高,但小模型在长程决策任务中能与更大模型同场竞争,这个信号值得观察。

预计阅读 30 秒
03
论文作者(Zhixu Du 等) 研究/Benchmark arXiv cs.AI

论文作者(Zhixu Du 等):What Does a Token Cost? A Mixture-of-Agents Measurement of Sufficient Per-Token Compute

AI Summary该论文提出用MoA面板逐token复现参考序列,测量每个token的充分计算量:0.5B模型可复现92-95%的token,最贵10%的token占64-80%FLOPs,并将其用于路由和草稿生成以降低延迟。

解读Token难度并不均匀,给每个token定出“够用”的计算量后,路由和投机解码就能省算力;但测得的是充分上界,不是真实必需。

预计阅读 35 秒
04
Apple 研究/Benchmark Apple Machine Learning Research

Apple:Negotiating Ontological Boundaries in User-Authored Personal Sensing Systems

AI Summary苹果机器学习研究团队与斯坦福合作发表 HCI 论文:用 Wizard of Oz 探针让用户定义并训练个性化感知系统,识别出现象边界、关系中主体、信号与噪声、数据客观性四类本体论边界协商。

解读这是 HCI 设计研究而非模型能力突破,核心贡献是提出本体论边界协商框架。

预计阅读 35 秒
C

行业观点

X 大 V · YouTube / Podcast · Builder 观察 · 开发者讨论

01
OpenAI 行业动态 XPeter Yang

解读用户视角的界面复杂度批评,核心是产品品牌碎片化,Work 独立品牌被视为失败设计,简化是头部产品从扩张转向收敛的信号。

预计阅读 2 分钟
02
AI 模型/产品发布 XNikunj Kothari
预计阅读 2 分钟