工程实践
AI DAILY BRIEF · EVENT NOTES · 2026.11.07
for AI era builders
EDITORIAL BRIEF
AI 行业简报 2026-11-07
今天筛出 10 个事件:大厂动态 5 条,技术进展 3 条,行业观点 2 条;另读 Hugging Face Papers 5 篇。
本期先发布已核实内容,仍有27条重要线索未完成核实,暂未收录;核实后将继续补充。
TOP 3 · 今日重点
先读重要变化,再看技术细节Agent 技术
Anthropic 撰文拆解 Agent 记忆组件,介绍 Claude 用“dreaming”反思日志并校正记忆笔记。
阅读解读与来源 →算力硬件与基础设施
路透社报道:约60万颗英伟达先进芯片因中国入境审批滞留香港。
阅读解读与来源 →按主题查阅 10 个事件
基础模型与技术0
本期暂无达到入选标准的新内容
行业 / 商业动态1
工程实践2
算力硬件与基础设施1
政策、安全与社会影响1
A
大厂动态
AI 公司动态 · 模型发布 · 新业务 · 融资投资 · 人员变动
路透社报道:约60万颗英伟达先进芯片因中国入境审批滞留香港。
事实摘要
据路透社报道、Semafor 转述,约60万颗英伟达先进芯片在运往中国途中滞留香港,原因是北京方面担忧本国企业过度依赖西方技术而未准其入境。 报道称,尽管中国在推动半导体自给,国内科技公司对算力的庞大需求仍造成供给短缺,促使它们加大进口。
报道还提到,美国共和党议员呼吁英伟达 CEO 黄仁勋就其与一名被控向北京提供情报的女商人之间被指的关联,向议员作说明。
编辑解读
该报道未披露芯片具体型号、滞留时长及中方审批口径,也未包含英伟达与中国监管部门的回应,后续应跟踪放行、退运或转售其他市场的结果。
预计阅读 60 秒
美国九州逾30地选民投票支持暂停或禁止数据中心。
事实摘要
据 Semafor 报道,美国九州逾30个地方选民投票支持暂停、禁止或其他限制数据中心的措施,部分直接针对在建项目。 佛罗里达州 Edgewater 选民投票将数据中心禁令写入城市宪章;
俄亥俄州 Perry 通过措施,对寻求税收优惠的超大规模企业施加财务和运营约束。 报道称,逾130场联邦和州长竞选出现反科技或反数据中心广告,得州州长 Abbott 也承诺更严格监管但落选;
银行和资管机构已把地方反对视为信用风险,超大规模企业则加紧招聘社区联络人员。
编辑解读
对 AI 算力扩张而言,地方选址与许可阻力已不只是单个项目问题;融资方开始把社区反对计入信用风险,运营方也在补社区联络能力。
预计阅读 65 秒
彭博社报道称,OpenAI 新一轮融资再募 110 亿美元、估值达 1.25 万亿美元。
事实摘要
彭博社报道称,OpenAI 新一轮融资再募 110 亿美元,估值达 1.25 万亿美元。 报道并称其 3 月曾以 8520 亿美元估值融资 1220 亿美元。
预计阅读 25 秒
Anthropic为Claude推出Personal Finance,经Plaid只读接入银行账户并在美国面向付费订阅用户Beta开放。
事实摘要
据The Decoder 11月6日报道,Anthropic为Claude推出Personal Finance功能,允许用户以只读方式连接银行与信用卡账户并向Claude提问个人财务问题,Claude不能移动、管理或投资资金。
账户连接通过Plaid完成,Claude不会接触用户的银行密码,用户可分类查看支出、检查待付款项;该功能以Beta形式在美国面向Pro、Max和Ultra订阅用户开放,Personal Finance区域的对话不会用于模型训练。
Anthropic表示用户可随时断开账户,功能不会展示广告或赞助推荐,长期计划连接持牌财务顾问与受监管机构;OpenAI已在美国提供类似的Finances功能。
编辑解读
把只读金融数据接入对话助手,难点不在连接本身,而在授权边界、数据留存与建议责任;Plaid通道、默认不训练和可随时断开划出了底线,Beta阶段的真实授权体验与错误建议风险仍需观察。
预计阅读 2 分钟
据报道前三星员工因向长鑫存储泄露技术被判五年,芯片人才争夺与商业秘密诉讼同步升温。
事实摘要
据CNBC报道,一名2016年转投长鑫存储(CXMT)的前三星电子员工,被首尔高等法院于10月22日以泄露三星技术判处五年监禁,较4月一审的七年有所缩短。
报道援引Counterpoint Research高级分析师Jeongku Choi称,中国存储厂商以高薪、股票期权、住房和家庭安置招募有经验的海外工程师,这些经验帮助其在美国出口管制限制先进设备获取的情况下突破技术瓶颈。
该分析师称中国厂商已从难以追赶变为“有分量的竞争者”,Counterpoint 2026年第二季度内存追踪报告预计CXMT在全球DRAM营收中的份额将达10%;三星与CXMT均未回应CNBC的置评请求。
编辑解读
商业秘密诉讼随人才流动升级,反映国产存储工艺已进入韩系厂商需要设防的区间;对芯片与AI基础设施团队来说,竞业条款与知识产权边界正在成为招聘的硬约束。
预计阅读 2 分钟
B
技术进展
Hugging Face · 技术报告 · 论文 · Benchmark · RL 研究
HF PAPERS
查看当天论文
Hugging Face Papers 速读
逐篇读取当天 paper 页面,由 deepseek-v4-1-flash-261017 生成中文摘要。


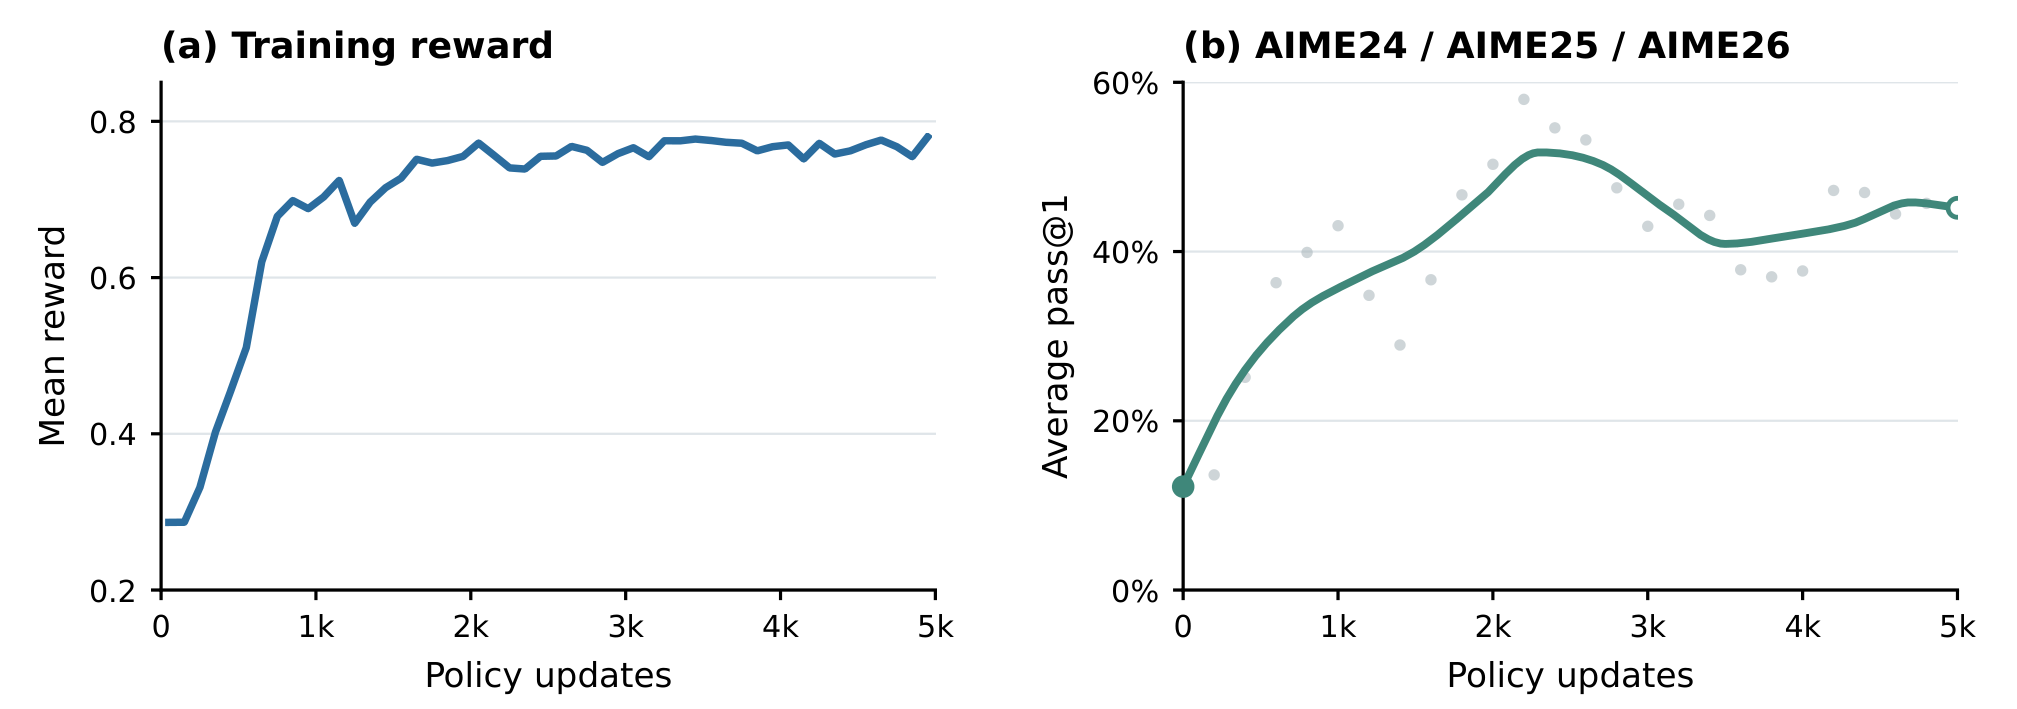
NVIDIA Research与Inferact提出REINFORCE Zero零失配异步RL,报告训练步吞吐达同步训练2.40倍并覆盖DeepSeek-V4.1-Flash与Kimi K3.1。
事实摘要
《Zero Mismatch, Simple Async RL》介绍NVIDIA Research与Inferact的REINFORCE Zero,将异步RL的rollout-学习器差距拆为平滑的权重滞后与波动的内核失配。
方法让rollout与训练器在相同权重和token上逐位对齐logprob,再用未裁剪token级重要性采样修正权重滞后、无需拒绝门;
论文报告16 GPU、12K更新下训练步吞吐为同步训练2.40倍(68.55对164.77小时),并在Qwen3-4B+Python工具上以滞后64训练5,000步,平均奖励从0.287升至约0.78。
零失配现覆盖DeepSeek-V4.1-Flash(DAPO rollout步在快速基线10%内)和发布日的Kimi K3.1,也在AMD MI355X上验证,代码与配方已开源。
编辑解读
此前同步RL已演示rollout与训练可逐位一致,此次把零失配扩展到异步RL,并新增DeepSeek-V4.1-Flash与Kimi K3.1的适配。
预计阅读 2 分钟
Anthropic 撰文拆解 Agent 记忆组件,介绍 Claude 用“dreaming”反思日志并校正记忆笔记。
事实摘要
Anthropic 发布研究博客,称 Agent 记忆是 Claude 跨会话保留的上下文,不含权重更新、上下文内学习和压缩。
文章介绍“dreaming”机制,借用 Letta 与 UC Berkeley 的 sleep-time compute 思路,让模型在空闲时反思日志、校正错误并生成记忆笔记。
CL-Bench 1.0 数据库任务中,Opus 5 在这些模型中率先形成“记录失败—验证—写成规则”的闭环;
Pokémon Red 中,写 413 个文件的 Sonnet 3.7 仅获 1 枚徽章,只写 9 个文件加 global.md 的 Fable 5 获 4 枚。
编辑解读
Anthropic 研究博客用 CL-Bench 1.0 与 Pokémon Red 观察 Agent 记忆笔记、显著性判断和 dreaming 校正的作用。
预计阅读 65 秒
Debezium Server 3.7 起集成 Zerobus Ingest sink,可将数据库变更直接推入 Unity Catalog 的 Delta 表、不再需要中间 Kafka 集群。
事实摘要
Databricks 博客介绍,Debezium Server 3.7 起包含 Zerobus Ingest sink,可把源库变更事件从本地推送端直接写入受 Unity Catalog 治理的 Delta 表,省去作为传输层的 Kafka 集群。
该 sink 由 NVIDIA 与 Databricks 工程师合作构建并贡献给开源 Debezium:Databricks 负责 typed sink,NVIDIA 贡献 envelope 模式,把完整变更事件落入固定九列表,并附带投递保障。
保障机制包括由目标表、分区、key、操作与源位置派生的 SHA-256 幂等键,以及 Zerobus 确认批次持久化后才允许 Debezium 推进 offset;因此投递语义为至少一次,重复需在下游用 idempotency_key 处理。
Zerobus Ingest 本身为 append-only,落地后的变更流按 Bronze、Silver、Gold 分层处理,可折叠为当前态表或保留版本形成历史表。
编辑解读
博客中的 Debezium+Zerobus 与 Debezium+Kafka+Spark 架构对比表由 Databricks 自行撰写,其中“峰值时段无需调优”的说法尚无第三方压测佐证。
预计阅读 2 分钟
C
行业观点
X 大 V · YouTube / Podcast · Builder 观察 · 开发者讨论
图宾根学者在AI for Science客座文章中提出:LLM智能体可自动构建科学模型,但复现数据不等于获得洞见。
事实摘要
ELLIS图宾根研究所与图宾根大学的Jakob Macke、Daniel Gedon、Stefan Wahl在AI for Science客座文章中,把科学建模拆成构建模型、约束参数、解释模型三步,并称AI正越来越多地介入这三步。
在约束环节,作者介绍基于模拟的推断(SBI):对Hodgkin-Huxley这类模型需运行约10万次模拟,再用神经网络从输出反推可能的参数范围,训练完成后对新数据的推断可在数秒内完成。
在构建环节,LLM智能体可依据数据与自然语言描述写出候选模型代码,再运行、约束参数、与真实数据比对并修改方程形式,循环至拟合足够准确;作者称近两年已出现多个此类系统。
作者强调,形状不同的多个模型可以同等解释同一批数据,同一智能体两次运行甚至可能返回两个同样好的模型,只给出单一模型的系统会隐藏其他可能,因此复现数据并不等于获得洞见。
编辑解读
该文是方法论评述而非新系统发布,可与本主题下关于LLM智能体自动化的长期观察对照,但其提到的自动建模系统未在可见正文中具名或给出评测结果。
预计阅读 2 分钟
Databricks博文称企业AI转向多模型:客户平均在用模型数从4.2增至7.1,约四成为开源权重。
事实摘要
Databricks一线工程师在官方博客发文称,企业在连续两年把AI标准化到单一前沿模型供应商后,正因预算回报不足、模型排名反复变化、前沿模型护栏拦截合法任务、数据留存政策变动和治理可见性需求等七类压力重新评估策略。
文章引用Databricks自有基准称,同一模型在一套harness下得分61.7%,换另一套为48.1%,无harness裸跑为38.4%,因此评测应把模型与harness一起测。
其内部数据显示,在2026年1月5日至7月27日的周区间内,Unity Gateway客户平均在用的模型数从4.2增至7.1,其中约40%为开源权重模型;GLM 5.2在7月中旬上线一个月后约占该网关开源权重token的40%。
文章称开源权重模型已在基准上接近前沿模型且成本更低,并引用Artificial Analysis数据称GLM 5.3(max)在Databricks上的端到端响应时间为9.1秒。
编辑解读
Databricks在7月宣布30亿美元融资,其CEO对CNBC称融资部分用于获取托管开源模型所需的GPU算力。 该文的实质主张是模型与harness都可替换、并由统一网关做路由与治理,这比“开源追平闭源”的结论更接近可验证的工程要求。
预计阅读 2 分钟