基础模型与技术
AI DAILY BRIEF · EVENT NOTES · 2026.10.09
for AI era builders
EDITORIAL BRIEF
AI 行业简报 2026-10-09
今天筛出 17 个事件:大厂动态 10 条,技术进展 4 条,行业观点 3 条;另读 Hugging Face Papers 5 篇。
TOP 3 · 今日重点
先读重要变化,再看技术细节基础模型与技术
Anthropic 发布 Claude Haiku 5.5:登上 Amazon Bedrock,官方称较 Haiku 4.5 多数任务成本降低约 75%
阅读解读与来源 →AI 产品与工具
Anthropic 发布 Cyber Mission:推出关键基础设施防御计划与开源扫描服务 OSS Scanner
阅读解读与来源 →按主题查阅 17 个事件
基础模型与技术4
AI 产品与工具3
Agent 技术4
工程实践0
本期暂无达到入选标准的新内容
A
大厂动态
AI 公司动态 · 模型发布 · 新业务 · 融资投资 · 人员变动

云栖大会观察:阿里公布 Qwen 4/5 参数路线图与 RSI 实验,下一代视频模型11月发布
事实摘要
雷峰网报道,云栖大会上阿里披露 Qwen 规划:Qwen4 系列即将到来,Qwen4.5/Qwen5 计划迈向 5T—10T 参数;当前 Qwen3.8 为 2.4T,两年前 Qwen2.5 旗舰为 72B。
为控成本,Qwen3.8-Flash 以稀疏/线性注意力与外接记忆,每次推理仅激活 6B,训练成本降至九分之一、百万 Token 输入价格降至四分之一。
阿里还公布 RSI 实验:Qwen3.8-Max 60 多小时自主完成 NoC 芯片设计(面积 -42%、功耗 -59.5%),56 小时适配平头哥新 GPU(吞吐 +96%),并连续自主运行 33 轮实验。
多模态方面,下一代视频模型 11 月亮相,另有 Qwen-Image-3.1、Qwen-Audio-3.1、HappyShrimp1.1、HappyOyster 2.0 Preview。
编辑解读
阿里把 Scaling 竞争从“参数更大”延伸到“模型参与制造模型”:让 Qwen 改推理框架、写 EDA、设计实验,本质是用 RSI 压缩下一代模型的研发周期。若实验可复现,Qwen 迭代速度将从算力堆叠问题变成“模型多深入介入研发流程”的问题;
但目前证据均为单方发布,需谨慎对待。
预计阅读 2 分钟
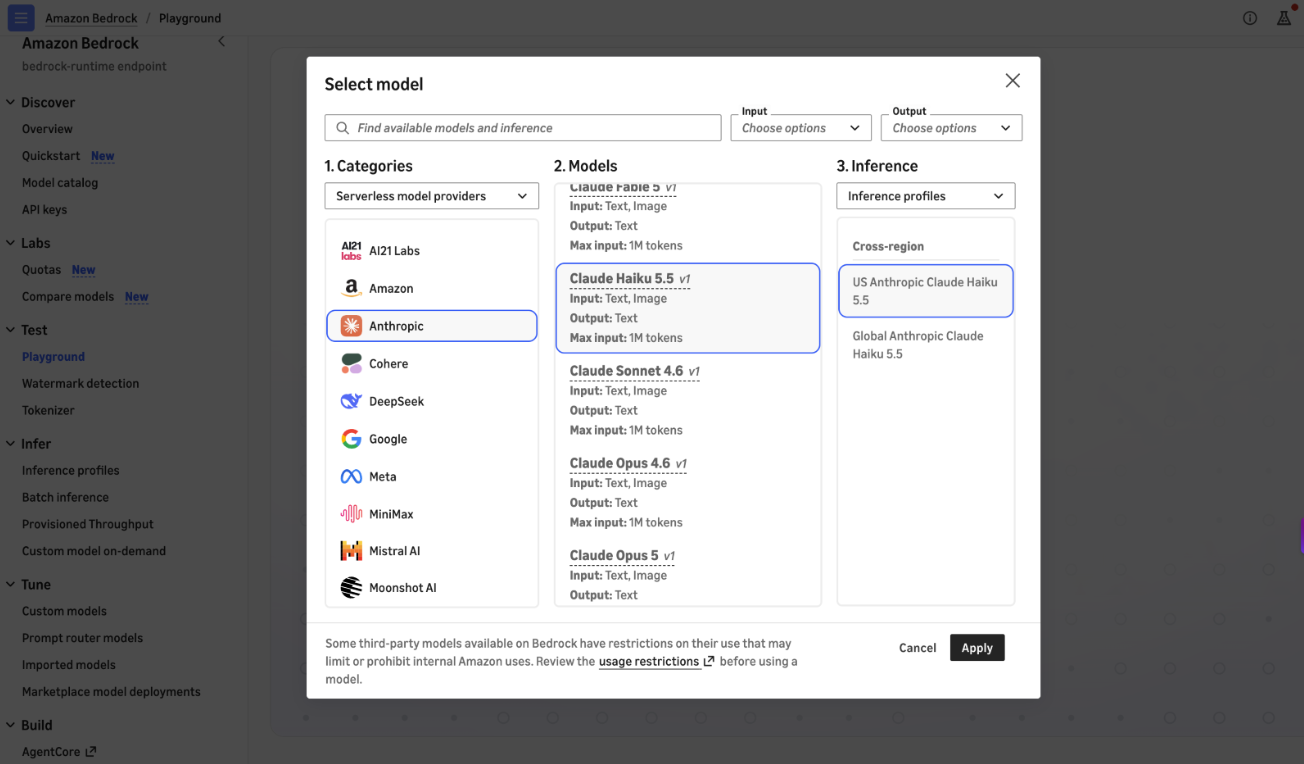
Anthropic 发布 Claude Haiku 5.5:登上 Amazon Bedrock,官方称较 Haiku 4.5 多数任务成本降低约 75%
事实摘要
Claude Haiku 5.5 现已上线 Amazon Bedrock 和 Claude Platform on AWS。
据 Anthropic 宣称,它是 Claude 5.5 家族中速度最快、效率最高的模型,专为 subagent 和高吞吐、成本敏感型任务设计,多数任务成本比 Claude Haiku 4.5 低约 75%。
这是首个支持 effort controls(按任务调节智能与成本)的 Haiku 模型,可用于编码子代理、代码审查、长文档分类、知识库快速问答、多步工具调用及高分辨率图像处理。
官方建议与 Opus 5.5 搭配:Opus 规划与判断,Haiku 执行高频低延迟工作。
编辑解读
Haiku 5.5 的定位很清晰:把推理成本从 Opus 层剥到 Haiku 层,用小模型承接 subagent 的重复性工作。75% 降本和 effort controls 是真实卖点,但能力边界仍要看具体 agentic 任务表现,而非官方描述。
预计阅读 75 秒
Anthropic 发布 Cyber Mission:推出关键基础设施防御计划与开源扫描服务 OSS Scanner
事实摘要
10 月 8 日,Anthropic 启动长期网络安全计划 Cyber Mission,主打两条线:关键基础设施防御计划(CIDP),用 Claude 前沿模型、现场工程师与威胁研究支持电力、水务、交运和政府系统防护,创始合作方包括 Accenture、CrowdStrike、Deloitte、PwC、Rockwell Automation 等 11 家;
开源方向推出 OSS Scanner,仿照 Google OSS-Fuzz,由最强模型免费为开源项目定期扫描,报告含 PoC、说明和修复建议,由模型生成、不经人工审核,Anthropic 预期真阳性率超过 90%。
Project Glasswing 已并入 Cyber Verification Program。
编辑解读
Cyber 正在成为 Anthropic 除模型能力外的一条可交付、可规模化的安全产品线。
相比“AI 发现漏洞”的能力叙事,真正的瓶颈是验证、分诊与修复链条,Anthropic 这次把资源投在了后者,值得跟进的是它与 Google OSS-Fuzz、OpenSSF 生态的分工能否真正落地。
预计阅读 75 秒

独家|清华AIR首届博士李健雄创立本溯智能,五源资本领投押注动作原生具身模型
事实摘要
据雷峰网独家报道,清华大学智能产业研究院(AIR)首届博士生李健雄毕业创立具身智能公司本溯智能(BASAL)。公司获五源资本领投,常春藤、线性、华山资本跟投;清华AIR副教授詹仙园任首席科学家。
本溯智能不走“预训练基模+后训练部署”主流范式,押注动作原生的In-Context具身基础模型,目标是让机器人遇到新场景时无需重新训练,通过少量示范在几分钟内完成现场学习。
其核心支撑为跨具身模型X-VLA和隐空间世界模型ODEWorld,其中X-VLA仅用不足1000小时预训练数据,在IROS 2025智元机器人挑战赛从400多支队伍中夺得总冠军。
编辑解读
押注“动作原生”而非语言中心,本质是赌具身智能的规模化瓶颈在跨场景泛化成本,而非交互自然度。这个定位有逻辑,但IROS单项冠军和不足千小时数据都不足以证明“几分钟现场学习”在工业场景成立,需观察其是否有公开评测和真实部署证据。
预计阅读 2 分钟
Anthropic承诺三年投入1.5亿美元支持Genesis Mission,Claude将覆盖NASA等15+联邦机构
事实摘要
Anthropic于10月8日在白宫科技政策办公室举办的“科学:新黄金时代”峰会上宣布,三年内向美国联邦Genesis Mission计划投入1.5亿美元,使Claude、Claude Code及API积分覆盖NASA、国立卫生研究院、国家科学基金会在内的15个以上参与机构,面向数百个研究项目;
合作聚焦聚变能和量子计算等优先方向,并提供培训与技术支持。此举延续了去年12月与能源部及Genesis Mission的既有合作。此前Anthropic已推出Claude Science工作台,并为学术科学家开放1万个免费/折扣席位。
编辑解读
本质是一次科研生态位的战略卡位:Anthropic用1.5亿美元换取Claude在美国联邦科研体系中的早期嵌入。
相比单纯捐款,通过API积分、培训和项目合作,让Claude、Claude Code变成国家实验室和联邦机构的工作流底座,后续沉淀的数据与反馈比金额本身更有价值。
预计阅读 75 秒

Naive AI成立7个月融资4亿美元、估值14.2亿美元,代季峰8人团队背景与技术路线首次曝光
事实摘要
据雷峰网报道,清华大学副教授代季峰2026年2月创立的Naive AI(工商名北京智衍慧生)成立7个月完成三轮融资共4亿美元,投后估值14.2亿美元,投资方含腾讯、博裕、红杉中国、IDG、经纬等。
公司技术路线是不预训练,基于开源基座MiMo-V2.5做中期训练与后训练,已发布首款模型Naive-N0.5-Flash(309B MoE、激活参数15.5B、原生百万token上下文、MIT协议开源)。
8人核心团队来自MSRA、商汤、上海AI Lab,合作近十年,合计引用超24万次。代季峰与陈天桥的MiroMind合作于2026年1月终止。
编辑解读
这轮融资的本质是"投人",押注代季峰团队近十年协作积累,而非产品指标。更值得注意的是"不预训练、只做后训练"的路线:开源基座成熟后,顶级学术团队绕开预训练烧钱阶段,直接做Agent化与持续学习改造,正在成为新的创业范式。
预计阅读 2 分钟

Google 推出面向企业的 Gemini Agent:单一界面跨应用分配任务、云端自动执行
事实摘要
据 The Verge 报道,Google 在“Gemini at Work”活动上推出面向企业的“universal” Gemini agent:用户可在 Gemini Enterprise 应用内通过单一界面与代理对话、分配任务,代理在云端后台跨应用和设备执行。
其支持 Gmail、Drive、Docs、Sheets、Calendar 等 Workspace 应用,也覆盖移动端、桌面、网页及 Slack、Microsoft 365 等第三方入口,并可在所有连接设备间保持统一上下文。
Google 表示代理可调用任务专用子代理,也能以拥有独立身份和“@agents.company.com”邮箱的“同事代理”形态运作,并自动选择最适合任务的模型。该产品目前仅向企业客户提供 private preview。
编辑解读
此次发布意味着 Gemini 从“聊天/单任务助手”升级为具备常驻身份、跨应用协调和执行能力的企业代理层;真正价值不在入口统一,而在子代理、自动选模型和身份治理能否构成可靠的任务执行闭环。
预计阅读 2 分钟
Snyk将内部支持Agent产品化为Snyk Assist:9月进入核心产品,已处理超6万次查询
事实摘要
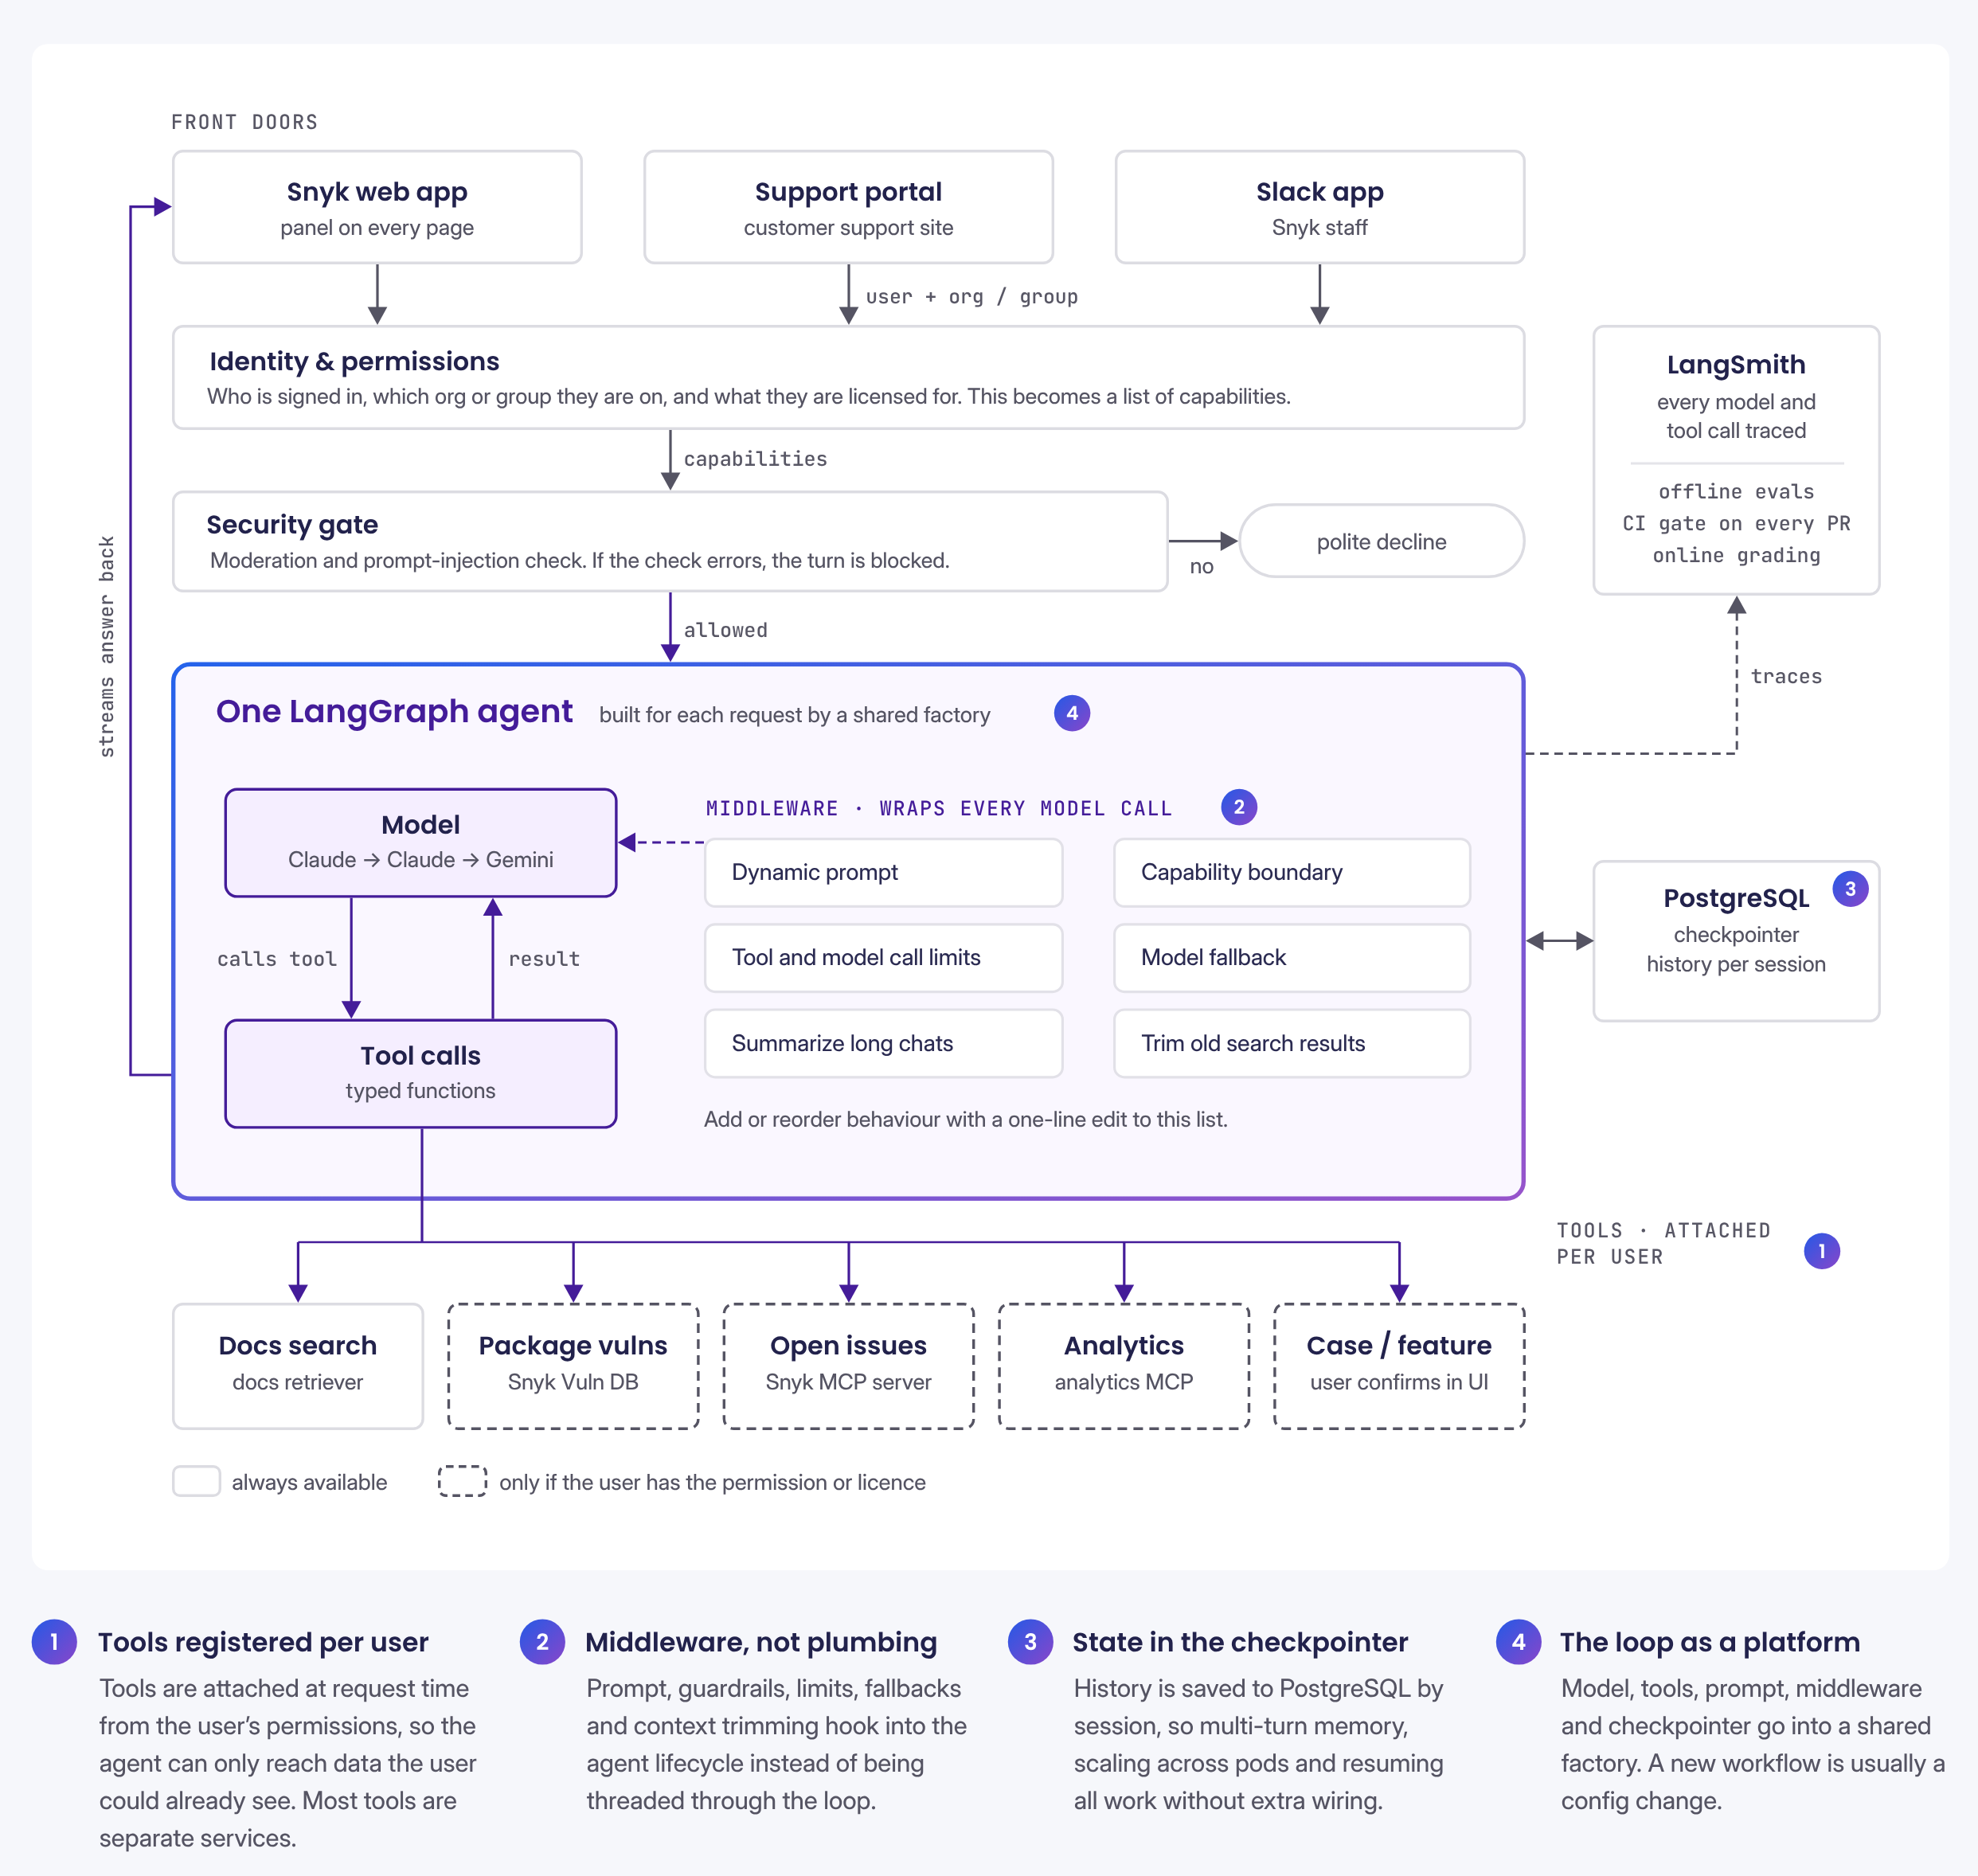
Snyk在LangChain官方博客披露,其内部支持Agent已产品化为客户功能Snyk Assist:该会话代理基于LangChain与LangGraph构建,LangSmith负责追踪与评估;
先面向内部支持团队运行约一年,2026年4月上线支持门户,9月1日嵌入核心Snyk产品,供所有付费客户使用。
架构上以单一LangGraph运行时支撑Slack、Web与API多入口,工具按用户权限注册,状态经checkpointer持久化到PostgreSQL,并通过离线评测、CI门禁与在线分级评估把关发布。
公司称自4月上线以来已处理超6万次查询、覆盖500多个客户账户,85%以上会话未生成支持工单,250余案例被自动升级到对应团队。
编辑解读
企业Agent落地的真正门槛不是模型推理能力,而是权限隔离、状态管理与可审计的评估门禁;Snyk用单运行时加权限工具注册把内部工具推向付费产品。案例数据来自LangChain官方博客,宜看工程机制,不宜全盘采信宣传数字。
预计阅读 2 分钟

Claude Haiku 5.5 发布:OSWorld 2.1 升至 72.4%、成本降约 75%,复杂终端编程仍落后 Sonnet 5.5
事实摘要
Anthropic 发布 Claude Haiku 5.5,主打低成本小模型升级。
据评测,其 OSWorld 2.1 离线子集从上一代 15.7% 升至 72.4%(Sonnet 5.5 为 83.9%),GDPval-AA v2.1 达 1620 分,较 Haiku 4.5 的 735 分大幅提升;
但 Terminal-Bench 4.0 仅 39.2%,明显低于 Sonnet 5.5 的 70.6%。模型首次支持 Adaptive Thinking 自适应推理,可按任务动态分配计算,并支持 100 万 Token 上下文。
定价分档:≤10 万 Token 输入 $0.10/M、输出 $0.50/M;超过 10 万 Token 后输入输出均涨 5 倍。Anthropic 称平均运行成本下降约 75%,Sonnet 5.5 缓存读取价同步降 50%。
编辑解读
Haiku 5.5 的核心不是简单降价,而是用自适应推理把“按任务动态分配计算”产品化——成本下降建立在小模型+短上下文假设上;一旦任务变长或复杂(如终端编程),价格和性能都会快速反弹。这意味着小模型降本叙事存在明确边界,选型必须按真实工作负载核算。
预计阅读 2 分钟

北醒李远:上半年交付25万台机器人雷达、收入占比超50%,NOVA20以时分复用切入具身感知
事实摘要
雷峰网发布北醒创始人李远深度访谈。李远称今年上半年北醒交付25万台机器人用激光雷达,机器人业务收入占公司营收超50%,2025年该业务收入较2024年翻倍;海外收入占比亦超过50%。
面向具身智能的新品NOVA20采用20点线阵加时分复用逐点探测,以解决点间串扰问题,可在毫秒级完成近场感知,盲区仅数厘米,产品约啤酒瓶盖大小、成本定位于消费级。
李远同时提出,激光雷达是物理真值的表达器,与摄像头多模态融合、用于增强基础模型对物理世界的理解是必然方向。
编辑解读
这篇访谈本质是激光雷达公司避开车载价格战、主动把机器人确立为主战场的公司叙事。真正有信息量的是两个技术动作:NOVA20把车载阶段的时分复用压缩到啤酒瓶盖大小的消费级器件,以及让感知服务于毫秒运动控制的定位取舍。
收入翻倍的具体客户结构,受访者并未给出证据。
预计阅读 2 分钟
B
技术进展
Hugging Face · 技术报告 · 论文 · Benchmark · RL 研究
HF PAPERS
查看当天论文
Hugging Face Papers 速读
逐篇读取当天 paper 页面,由 deepseek-v4-flash-ga-260731 生成中文摘要。


TokenRouter:面向Token级LLM路由的高效服务系统
研究摘要
论文标题提出TokenRouter,一个面向Token级LLM路由的高效服务系统,具体技术细节需查看完整论文。
LLM推理路由系统服务效率

AgentGarten:面向演进智能体的代码世界
研究摘要
提出AgentGarten框架,将模拟器与游戏引擎结合共享神经渲染器,构建实时交互环境,并引入对抗性强制方法加速智能体学习。
智能体仿真环境神经渲染


Agentic Language World Models 用于交互环境模拟
研究摘要
提出 Trace2Env,用世界模型代理基于历史交互轨迹模拟环境状态,无需重建原始可执行系统。
世界模型Agent环境模拟
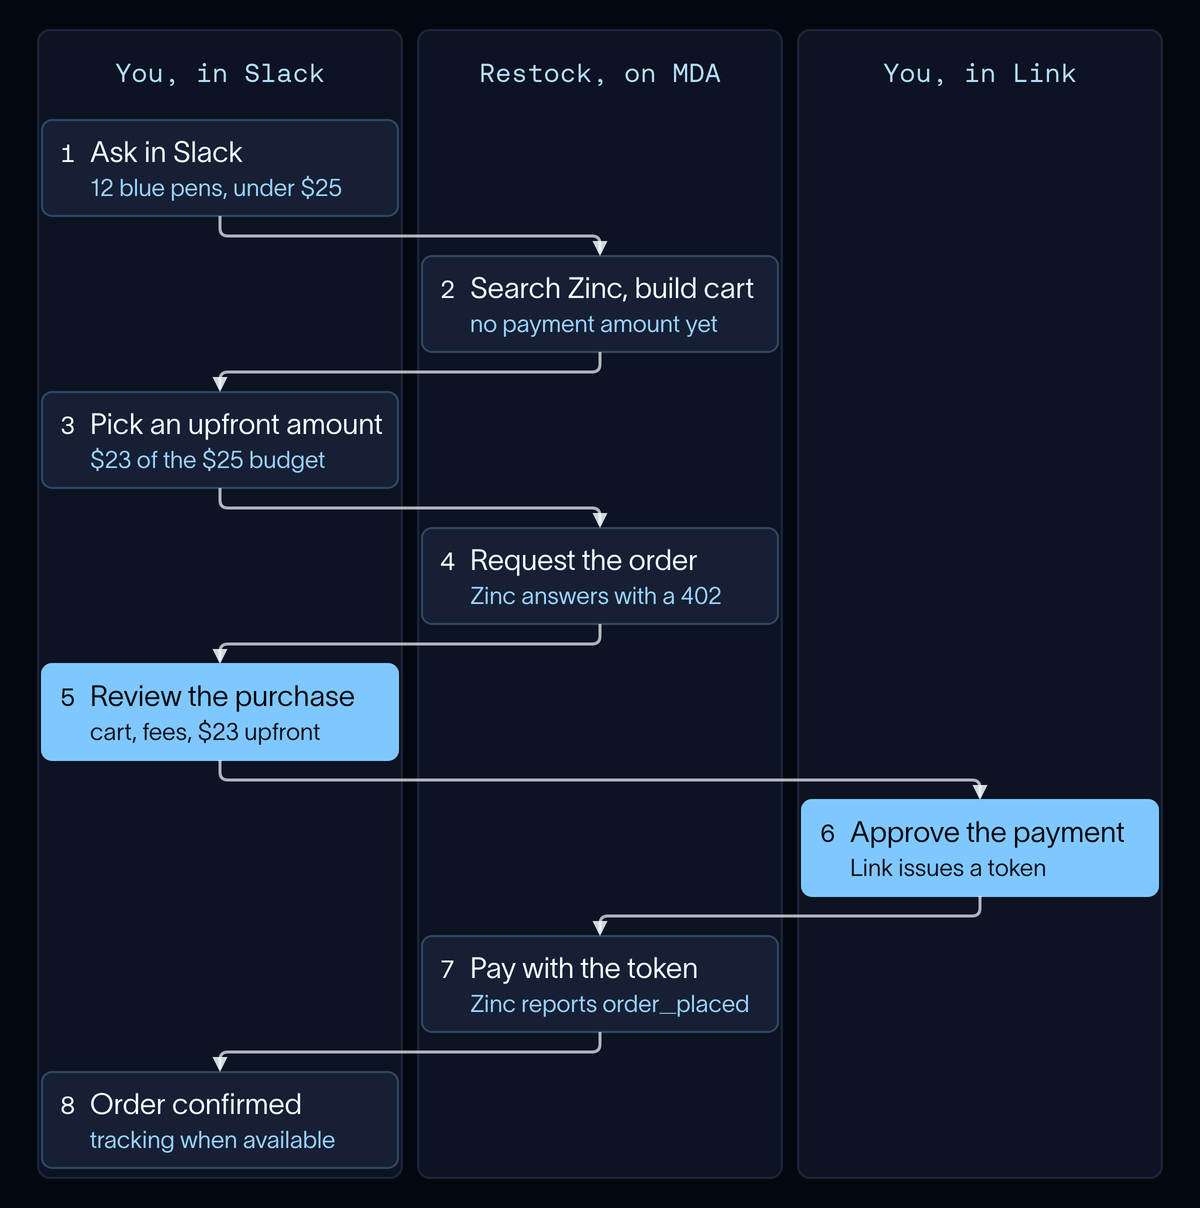
LangChain 开源 Restock 示例:让 Agent 通过 Stripe Link 与 MPP 完成真实采购支付
事实摘要
LangChain 发布博客介绍 Restock,一个运行在 Slack 上、基于 Managed Deep Agents(MDA)的办公用品采购示例 Agent。
它搜索商品、构建购物车,并通过支持 Machine Payments Protocol(MPP)的 API(如 Zinc)完成真实支付,搭配 Stripe 消费钱包 Link 处理付款,模型全程不接触卡号等敏感凭据。
用户需在 Slack 审批购物车、在 Link 网站确认付款,且消费被限制在预先设定预算内。文中示例为一盒 12 支蓝色墨水笔,订单含费用共 22.18 美元,超出部分退款。
代码位于 langchain-samples/restock-agent,支持三种模式,仅限美国地址与美元。
编辑解读
这篇文章提供了 Agent 真实花钱的完整工程范式:搜索与建车交给模型,预算上限、审批和凭据处理锁在模型碰不到的代码与沙箱里。关键不在于支付协议本身,而在于重新定义 Agent 自主性的边界——能执行但无法突破授权额度,这比能力更强重要。
预计阅读 2 分钟
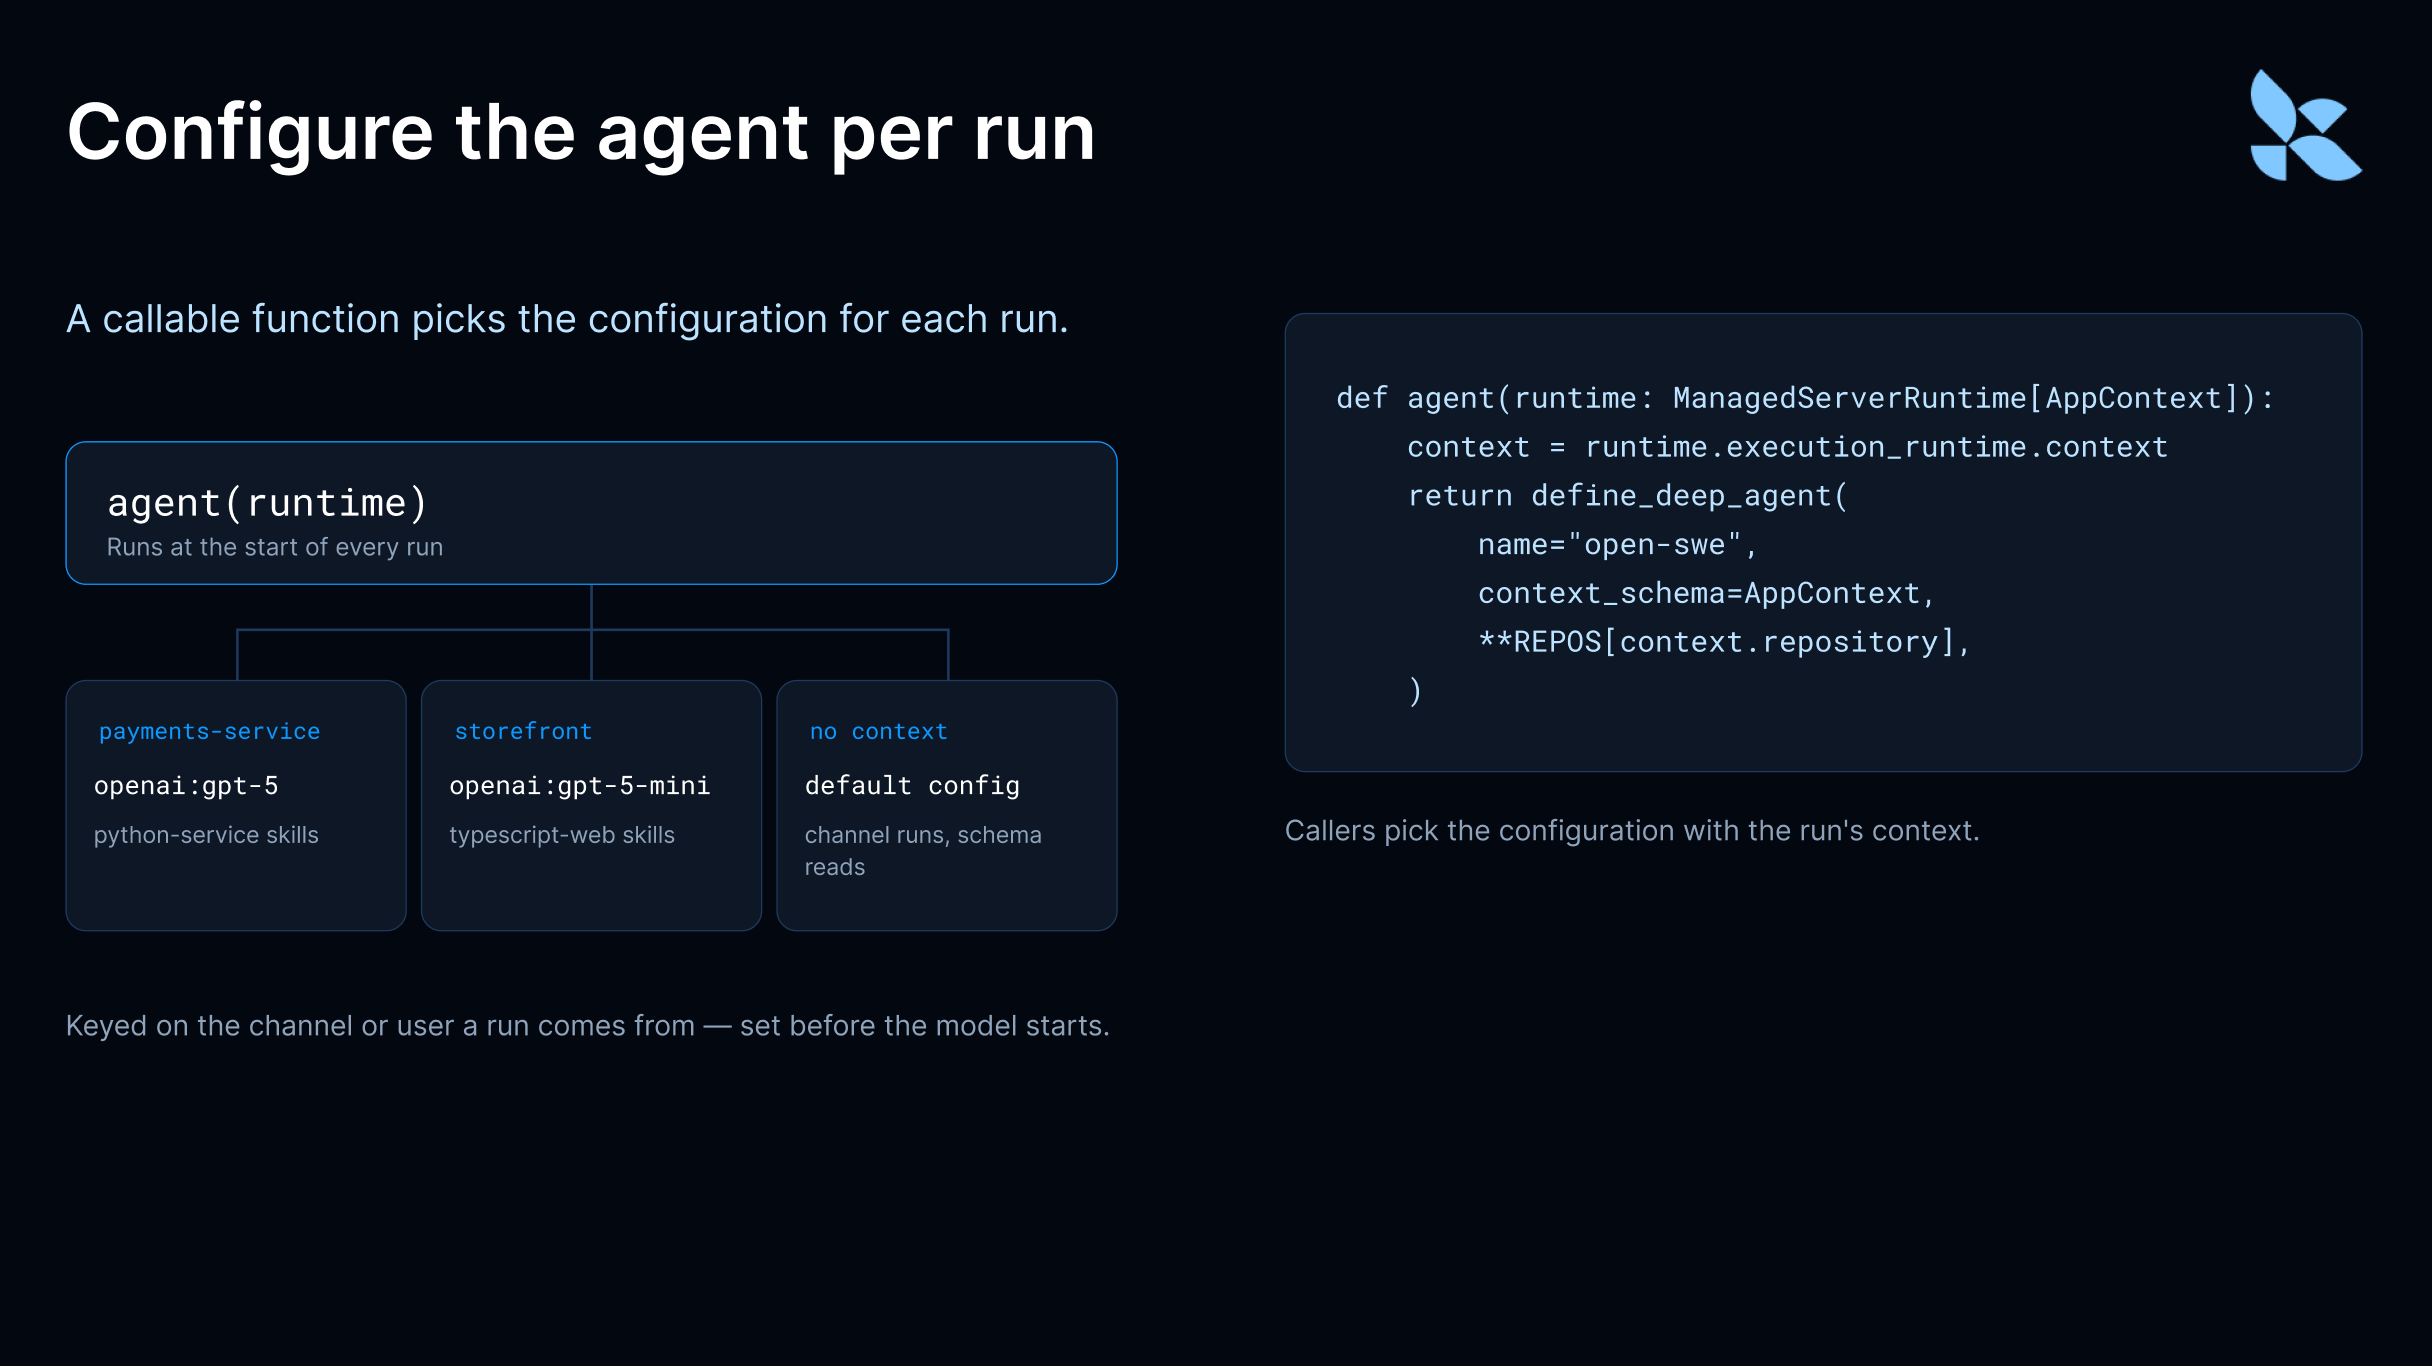
LangChain 发布 Managed Deep Agents v0.9:Agent 可自建定时任务、按运行动态配置,并支持 Slack 表情回应
事实摘要
LangChain 于 10 月 7 日发布 Managed Deep Agents v0.9(Public Beta)。
新增三块能力:Schedules SDK 让 Agent 在会话中自建提醒、跟进与周期性任务,定时任务以发起用户的身份和权限运行,结果回传原频道,支持 cron 和一次性 at 调度;
部署可写成函数,按每次运行的上下文动态配置模型、指令、技能、MCP 服务器与沙箱,配置在模型运行前生效,既压缩上下文也充当访问控制;Slack 频道默认在回复前发送 👀 表情,可按消息内容定制表情选择。
v0.8 已加入按用户记忆、自定义 HTTP 频道及 Parallel 驱动的联网搜索。
编辑解读
本质是从“让模型在运行时自己选工具”变为“运行前由宿主确定配置”,把工具可见性变成访问控制手段,既消除非确定性也压缩上下文。方向是平台化——一套部署通过 context 服务多个团队和仓库,边界问题在于调度与权限模型在真实多租户下的表现。
预计阅读 2 分钟
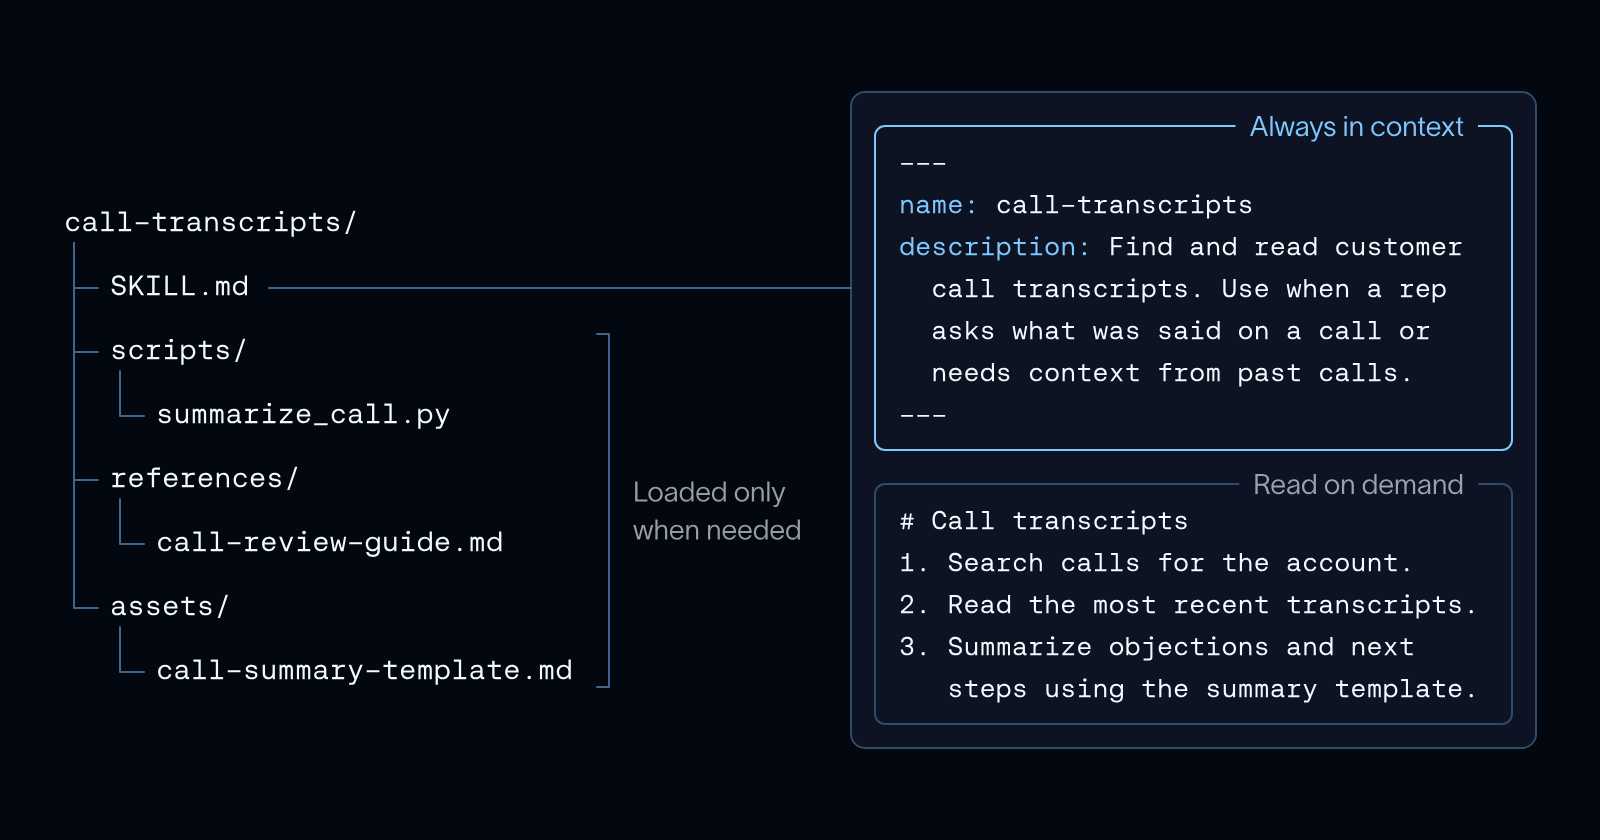
LangChain 重构 Deep Agents 技能系统:工具绑定技能、运行时固定与线程内热重载
事实摘要
LangChain 官方博客介绍了 Deep Agents 框架技能(Skills)系统的三项更新:工具可绑定到技能,工具 schema 在 agent 读取技能前不进入上下文,且支持对话中途接收新工具的 Anthropic/OpenAI 模型可保持提示缓存(prompt cache)不变;
应用可在运行时固定技能(如 /meeting-prep),使指令在首次模型调用前就进入上下文,省去 read_file 往返;
长线程可重载技能,将 skills_metadata 设为 None 即触发技能库重扫,加载新增或修改的技能而无需新开线程,但系统提示变化会使缓存失效。
技能基于 SKILL.md 和渐进式披露原则,仅名称与描述常驻上下文,文中 GTM agent 示例使用了 50 多个技能。
编辑解读
技能管理的本质是把上下文工程产品化:渐进式披露解决技能库膨胀与上下文预算的矛盾,工具绑定和固定技能把工具装载时机与指令前置变成声明式配置。提示缓存保真成为设计一等公民,说明长线程 agent 的成本优化已从模型层延伸到框架层。
预计阅读 2 分钟
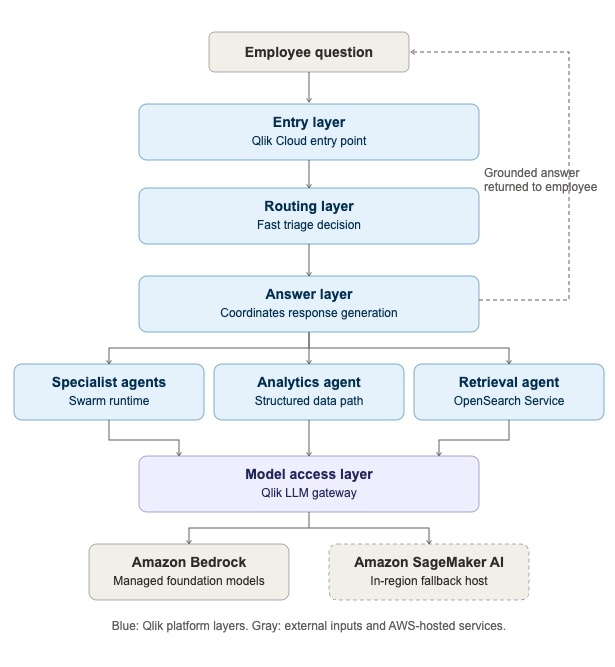
Qlik 基于 Amazon Bedrock 构建 Qlik Answers:分层多智能体架构实现可溯源企业级问答
事实摘要
Qlik 在 Amazon Bedrock 上构建并正式推出企业级问答产品 Qlik Answers,面向全球 4 万多家客户提供带来源、可核验的答案。
系统采用分层多智能体架构:入口层保持对话入口稳定,路由层只做快速分类,答案层区分简单与复杂路径,并通过统一 LLM 网关接入 Bedrock 的聊天、流式、Embedding 和重排能力;
所有请求经 Bedrock Guardrails 做提示注入、PII 过滤与 grounding 校验。
自 2026 年 2 月正式可用以来,Discovery Agent 已为客户发现超 10 万条异常,Lintech International 索引超 1.7 万份文档,响应速度提升 75%;
跨区域推理服务 11 个区域,容量提前 3–6 个月预测。
编辑解读
这篇文章的真正价值在于把 RAG 的“接地”从检索步骤升级为经过校验的生产控制,并用统一 LLM 网关将模型选择与应用逻辑解耦,使多区域部署和多模型切换成为可运维的常态。
不过所有数据来自 AWS 与 Qlik 的自述,“10 万条发现”和“75% 提速”缺乏第三方验证,更适合当作参考架构而非性能证据。
预计阅读 2 分钟
C
行业观点
X 大 V · YouTube / Podcast · Builder 观察 · 开发者讨论

华为推OceanStor M900为KV Cache单独存储,行业专用SSD规格仍待定型
事实摘要
在华为全联接大会上,华为推出面向KV Cache分层存储的OceanStor M900,英伟达也发布了CMX Context Memory Storage,将可复用KV缓存外置以减少重复计算。
受访专家称其逻辑是“以存换算”:KV命中率从90%提到95%,重算部分从10%降到5%;但DRAM替换为企业级SSD并非1:1,而是1:N,部分方案达1:5甚至1:10,同容量成本相差数十倍。
目前专用SSD标准未定,DWPD要求已从3升至9,行业统一共识预计需6至12个月,产品开发或再花约1年;外置KV主要缓解DRAM压力,对HBM影响有限,存算一体在Prefill阶段收益更明显。
编辑解读
KV Cache外置正在从服务器内部资源调配走向独立共享存储层,但配套SSD规格明显滞后:DWPD、容量需求仍未收敛,说明“以存换算”的经济账还未形成行业共识,硬件标准化将决定这块市场能否规模化。
预计阅读 2 分钟

对 1933 篇 IROS 2026 论文的统计显示:大模型未“吃掉”机器人学,研究进入系统整合阶段
事实摘要
雷峰网对 IROS 2026 的 1933 篇论文做多标签统计:Robot Learning/Embodied AI 约 809 篇,Navigation/Planning 564 篇,Perception/Vision 556 篇,Control/Dynamics 546 篇,Manipulation 520 篇,Humanoid/Legged 约 213 篇;
明确涉及 World Model 仅 19 篇(约 1%),Reasoning/Memory 119 篇(占 6.2%)。文章认为大模型并未“吃掉”机器人学,而是嵌入规划、几何、触觉与控制等传统环节;
VLA 研究正转向效率、三维理解、长时记忆与系统集成,机器人研究进入“系统问题时代”。
编辑解读
这篇统计揭示了一个常被媒体热度掩盖的事实:机器人学没有因大模型变成单一 AI 问题,反而在端到端狂奔后重新长出规划、记忆、几何、触觉等“中间层”。
真正的转折点是从追求模型预测能力转向构建能长期运行的机器人系统,这也预示未来竞争焦点在系统工程而非单一模型。
预计阅读 75 秒
The compute needed for the stage of AI we’re about to enter is going to be insane. Personal agents, agent swarms defending enterprises, agents that review all of our code for security issues, agents that process nearly all enterprise data in workflows, background agents working on tasks 24/7, and on and on. This will take a mix of inference volume that is going to keep growing by orders of magnitude, as well as infrastructure that agents need alongside the tokens. They need computers, networking, file systems, and so on. We’re only in the early stages of what this buildout is going to look like.
编辑解读
这则推文的本质是判断:AI 从对话交互走向大规模代理工作负载后,算力瓶颈将从训练转向推理和代理配套基础设施,且需求增量可能远超当前市场认知。这是观点而非实测,但代表了行业高管对下一阶段基础设施支出的预期方向。
预计阅读 3 分钟