行业 / 商业动态
AI DAILY BRIEF · EVENT NOTES · 2026.09.01
for AI era builders
EDITORIAL BRIEF
AI 行业简报 2026-09-01
今天筛出 14 个事件:大厂动态 5 条,技术进展 2 条,行业观点 7 条;另读 Hugging Face Papers 5 篇。
TOP 3 · 今日重点
先读重要变化,再看技术细节基础模型与技术
Anthropic:坚决不用行业标准AGENTS.md,Claude Code惹来“封杀令”:Anthropic终于回应了,但开发者更气了
阅读解读与来源 →Agent 技术
Amazon Web Services:Build observable enterprise agentic retrieval using Managed Amazon Bedrock Knowledge Base with AWS CloudFormation
阅读解读与来源 →按主题查阅 14 个事件
基础模型与技术3
行业 / 商业动态2
AI 产品与工具1
工程实践0
本期暂无达到入选标准的新内容
AI + 行业赋能0
本期暂无达到入选标准的新内容
A
大厂动态
AI 公司动态 · 模型发布 · 新业务 · 融资投资 · 人员变动
Polimill:Polimill builds Japan's next-generation public AI infrastructure
事实摘要
Polimill使用OpenAI GPT模型和Codex,帮助日本市政机构搜索和利用行政知识,同时加速其开发流程,构建日本下一代公共AI基础设施。
编辑解读
本质是政务知识检索加Codex提效的客户案例,技术含量取决于落地细节,而非模型能力展示。
预计阅读 25 秒
Anthropic:坚决不用行业标准AGENTS.md,Claude Code惹来“封杀令”:Anthropic终于回应了,但开发者更气了
事实摘要
因拒绝采用已被六万开源项目采用的 AGENTS.md 标准、坚持自有 CLAUDE.md,Claude Code 遭 Shopify CEO 公开放话禁用;Anthropic 回应称将提升可定制性,但未承诺默认识别。
编辑解读
本质是生态控制权之争。Anthropic 把模型特定指令的技术理由延伸到文件格式上,把适配成本转嫁给大型团队,可能削弱开发者信任。
预计阅读 35 秒
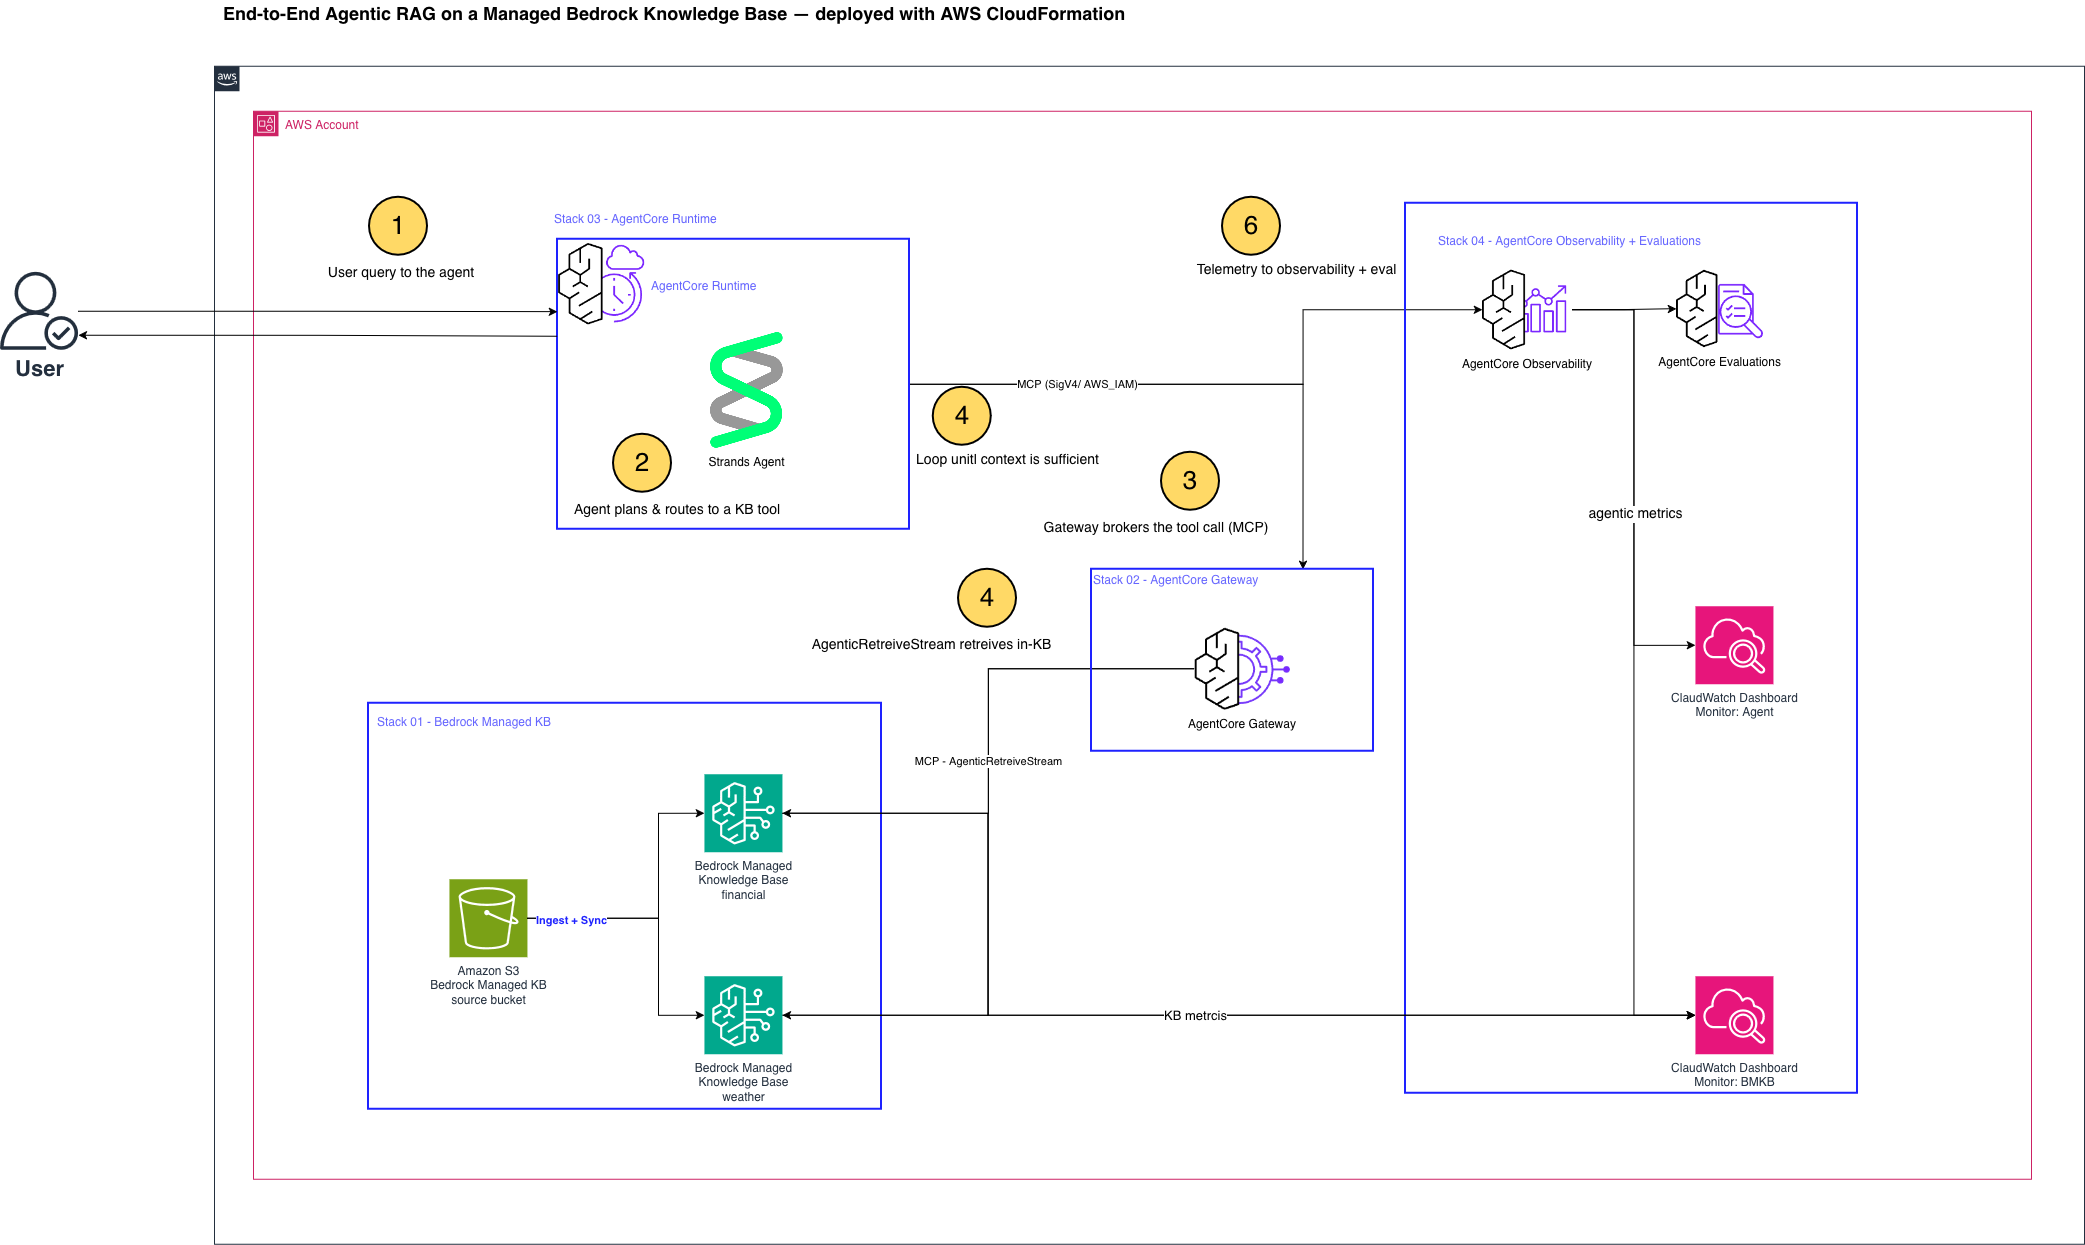
Amazon Web Services:Build observable enterprise agentic retrieval using Managed Amazon Bedrock Knowledge Base with AWS CloudFormation
事实摘要
AWS官方博客介绍如何基于Amazon Bedrock托管知识库与AgentCore,用CloudFormation一键构建企业agentic检索方案,实现跨知识库路由、迭代检索、带引用的回答,以及七层可观测性和两种。
编辑解读
RAG产品化正从单跳检索走向agentic路由,而可观测与评估才是企业部署的真实门槛。
预计阅读 35 秒
神奕科技:超千万元天使轮融资落定! 深圳神奕科技有限公司:AI融合BCI,让脑机智能普惠大众
事实摘要
深圳神奕科技完成超千万元天使轮融资,由力合创投领投、东莞生技跟投,资金将用于脑机接口技术研发、消费产品量产及医疗产品临床验证,公司聚焦AI+非侵入式BCI,布局睡眠与抑郁诊疗。
编辑解读
AI+BCI赛道早期融资信号,‘医疗+消费’双线逻辑成立,但闭环TI设备国内首个等说法需临床注册证验证,不宜过早乐观。
预计阅读 40 秒

腾讯(混元):混元Hy4 preview上线即排队,能消解腾讯的AI焦虑吗?
事实摘要
腾讯混元Hy4 preview上线即排队扩容:770B总参/49B激活/百万上下文/Apache 2.0。文章实测后认为混元已进开源第一梯队,但算力、安全披露与独立验证仍有缺口。
编辑解读
混元重建路线初步得到验证,但“第一梯队”叙事一半靠自家数据撑;49B激活旗舰上线即排队,算力和推理基建才是腾讯焦虑的下半场。
预计阅读 35 秒
B
技术进展
Hugging Face · 技术报告 · 论文 · Benchmark · RL 研究
HF PAPERS
查看当天论文
Hugging Face Papers 速读
逐篇读取当天 paper 页面,由 deepseek-v4-flash-ga-260731 生成中文摘要。
LoopArena:将模型作为循环工程运行时控制器的基准测试
研究摘要
提出LoopArena基准,评估一个模型(控制器)如何引导另一个固定编码智能体完成长时任务,并区分循环设计与编码能力的影响。
基准测试编码智能体循环工程

超越数据扩展:面向视觉-语言-动作模型的以表示为中心的继续预训练
研究摘要
论文标题表明提出一种面向VLA模型的以表示为中心的继续预训练方法,但摘要未提供具体实验细节。
预训练视觉-语言-动作模型表示学习
capability_comparison.svg(能力对比图)
研究摘要
摘要显示这是一幅性能对比图,涉及llama-cascade、unterschied和DIFFuser Teacher。
性能对比模型评估

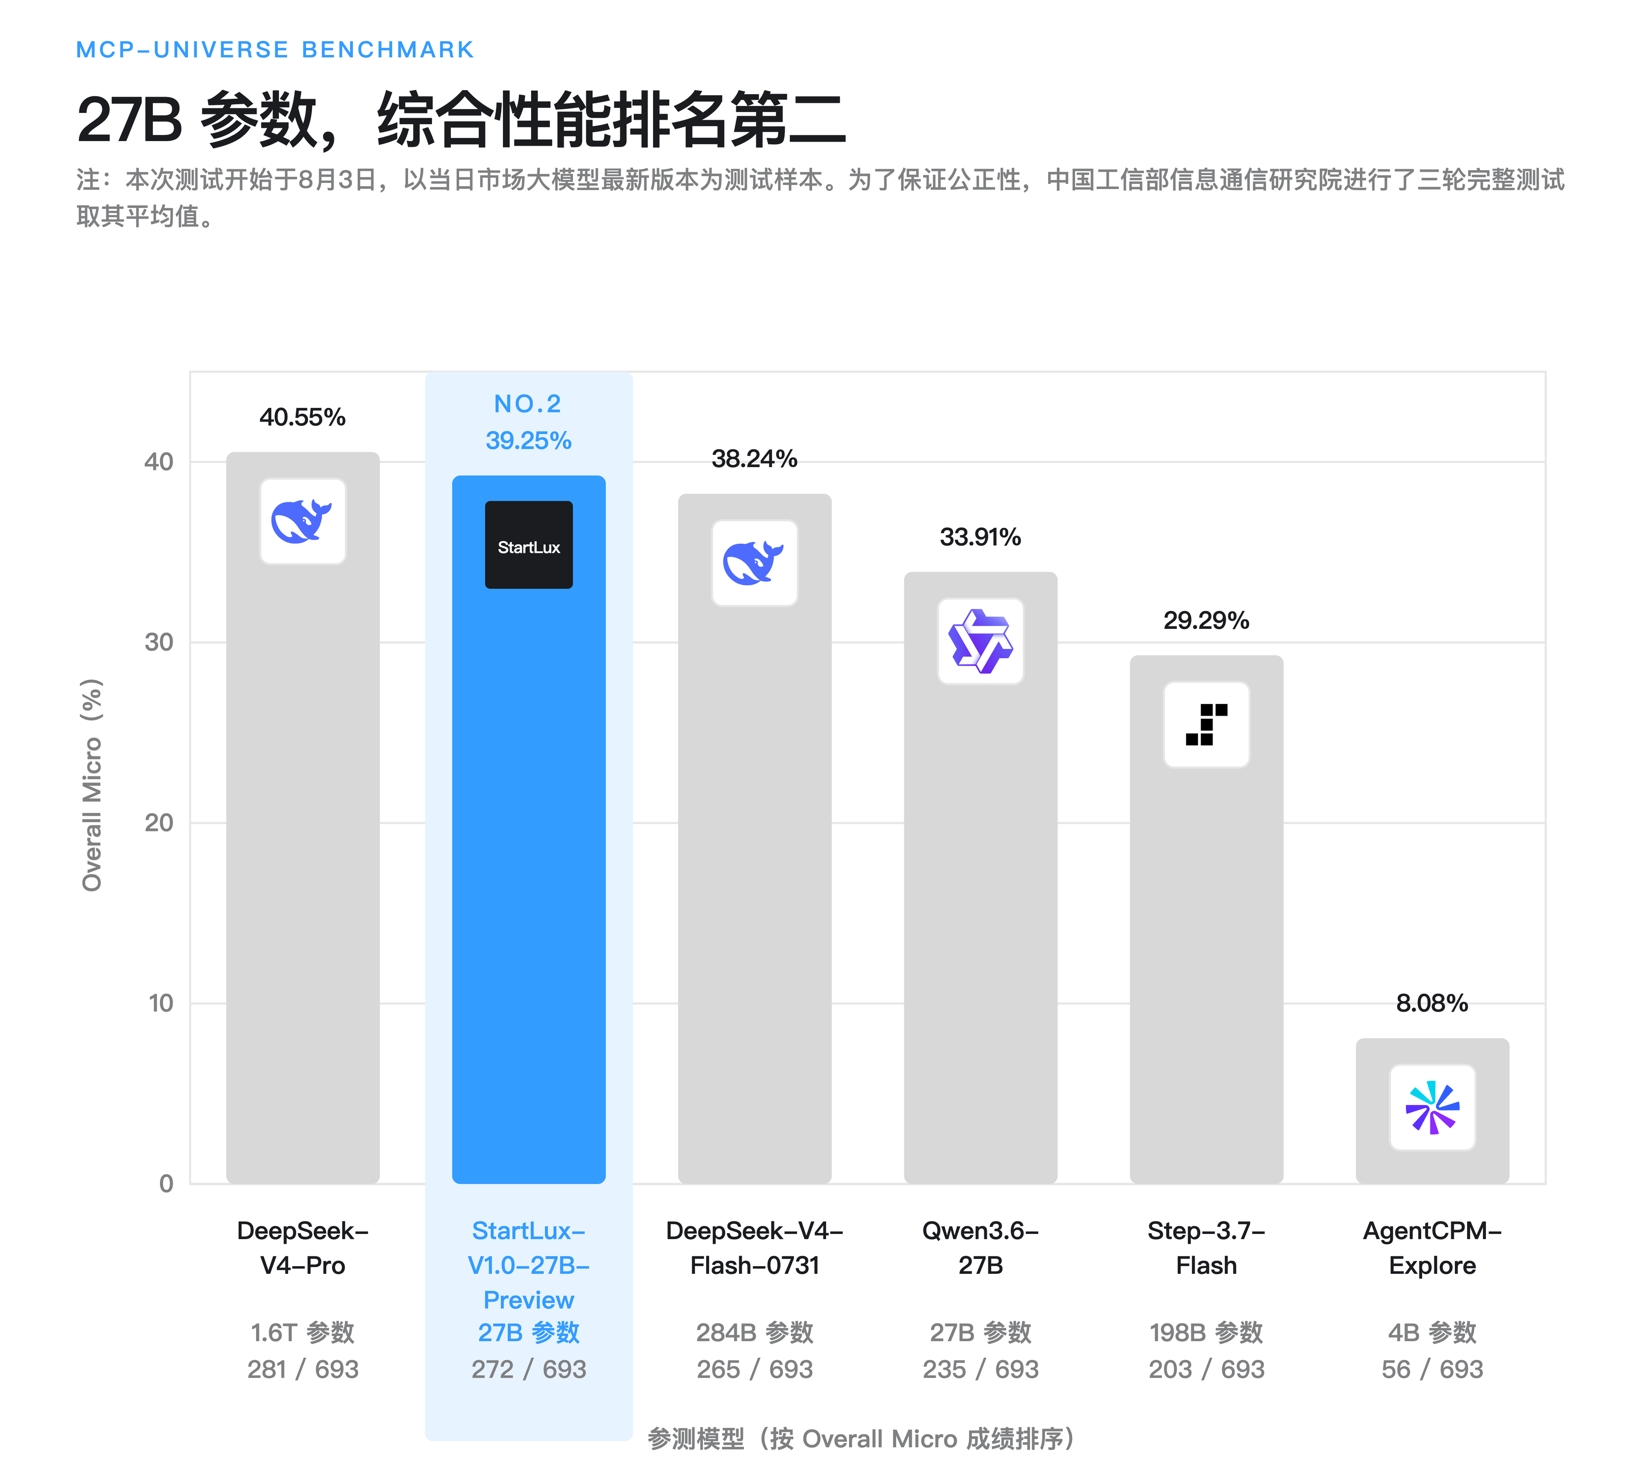
StartLux:最前线|本地大模型 StartLux-27B 通过 MCP-Universe 测评:综合第二,多项专项第一
事实摘要
信通院MCP专项测试中,StartLux-27B综合第二,多项专项第一,超过DeepSeek等更大参数模型,主打本地Agent模型。
编辑解读
小参数量模型靠后训练在Agent基准上追平万亿参数,关键看评测独立性和真实任务泛化。
预计阅读 25 秒
Qwen:Below the Noise Floor: Bimodal Seed Collapse and Distinct Failure Modes in Small-Model Knowledge Distillation
事实摘要
一篇arXiv论文在740实例医疗API路由任务上,用1.5B Qwen学生模型和20B教师比较8种知识蒸馏变体,发现单种子评估标准差高达48.7个百分点,多种变体出现双模态崩溃,只有progressive_kd和r。
编辑解读
单种子评估无法发现小模型蒸馏的失败模式,种子方差可吞噬所有声称的提升,双模态崩溃说明部分KD变体本质上不稳定。
预计阅读 40 秒
C
行业观点
X 大 V · YouTube / Podcast · Builder 观察 · 开发者讨论
David Gewirtz:5 ways I actually use ChatGPT Work in my small business to save time and money
事实摘要
作者以个人小企业主身份,分享使用 ChatGPT Work 的五个实际场景:扫描邮件、制作PPT、设计应用内购买策略、评估电路负载、审查贷款财务条款,并提醒结果仍需人工复核。
编辑解读
真实工作流中的agent应用案例,展示了ChatGPT Work在日常任务中的实用性和局限,但属于个人经验,不代表企业级结论。
预计阅读 35 秒
Armin Ronacher:“你以为买的是 DeepSeek Flash,到手可能是 1.5 bit 缩水版”:Pi 核心贡献者谈 AI Token 黑箱
事实摘要
Pi 核心贡献者 Armin Ronacher 在播客中谈 AI token 黑箱:模型量化版本难核实,缓存加密锁定用户,订阅补贴扭曲真实成本,生态绑定加剧。
编辑解读
本质是推理服务的商品化黑箱:用户付订阅费却无法验证实际模型质量与成本,厂商以缓存、加密实现生态锁定。
预计阅读 35 秒
For clarity, while both are called 20X, in Codex they apply specifically to weekly usage limits. And we also don't have 5h limits for both Pro plans. The Pro 20X is quite precisely 20X the usage of the Plus subscription, so it does exactly what it says on the tin. https://t.co/vMchMCT80Z
编辑解读
这是一次定价与权益的透明化澄清,防止“20X”被误解为限时或全局限制。
预计阅读 2 分钟
If you ever wondered how civilizations are built, it’s actually easy: [Agent() for _ in range(100)]
编辑解读
这是技术乐观主义的段子,把复杂系统工程简化为Agent数量问题,真实落地须考虑协调、反馈与基础设施。
预计阅读 40 秒