基础模型与技术
Anthropic:How an Anthropic field marketer uses Claude Code to send weekly personalized updates to every sales rep
Anthropic营销人员Adam Ward分享如何使用Claude Code将每周销售报告自动化为每个销售代表的个性化周一简报,通过BigQuery MCP拉取数据,并根据反馈迭代prompt规则。
阅读解读与来源 →EDITORIAL BRIEF
今天筛出 12 个事件:大厂动态 5 条,技术进展 1 条,行业观点 6 条;另读 Hugging Face Papers 5 篇。
基础模型与技术
Anthropic营销人员Adam Ward分享如何使用Claude Code将每周销售报告自动化为每个销售代表的个性化周一简报,通过BigQuery MCP拉取数据,并根据反馈迭代prompt规则。
阅读解读与来源 →行业 / 商业动态
OpenAI 宣布 GPT-5.6 现已集成到 Kiro 中,帮助开发者规划、构建、审查和测试软件,并强调更好的性价比。
阅读解读与来源 →Agent 技术
TechCrunch 报道 OpenAI 推出 ChatGPT Work,将 Codex 能力扩展到非工程师,让 AI 代理处理邮件、日历等白领工作,但外部采用率低,面临可用性和竞争挑战。
阅读解读与来源 →本期暂无达到入选标准的新内容
本期暂无达到入选标准的新内容
AI 公司动态 · 模型发布 · 新业务 · 融资投资 · 人员变动
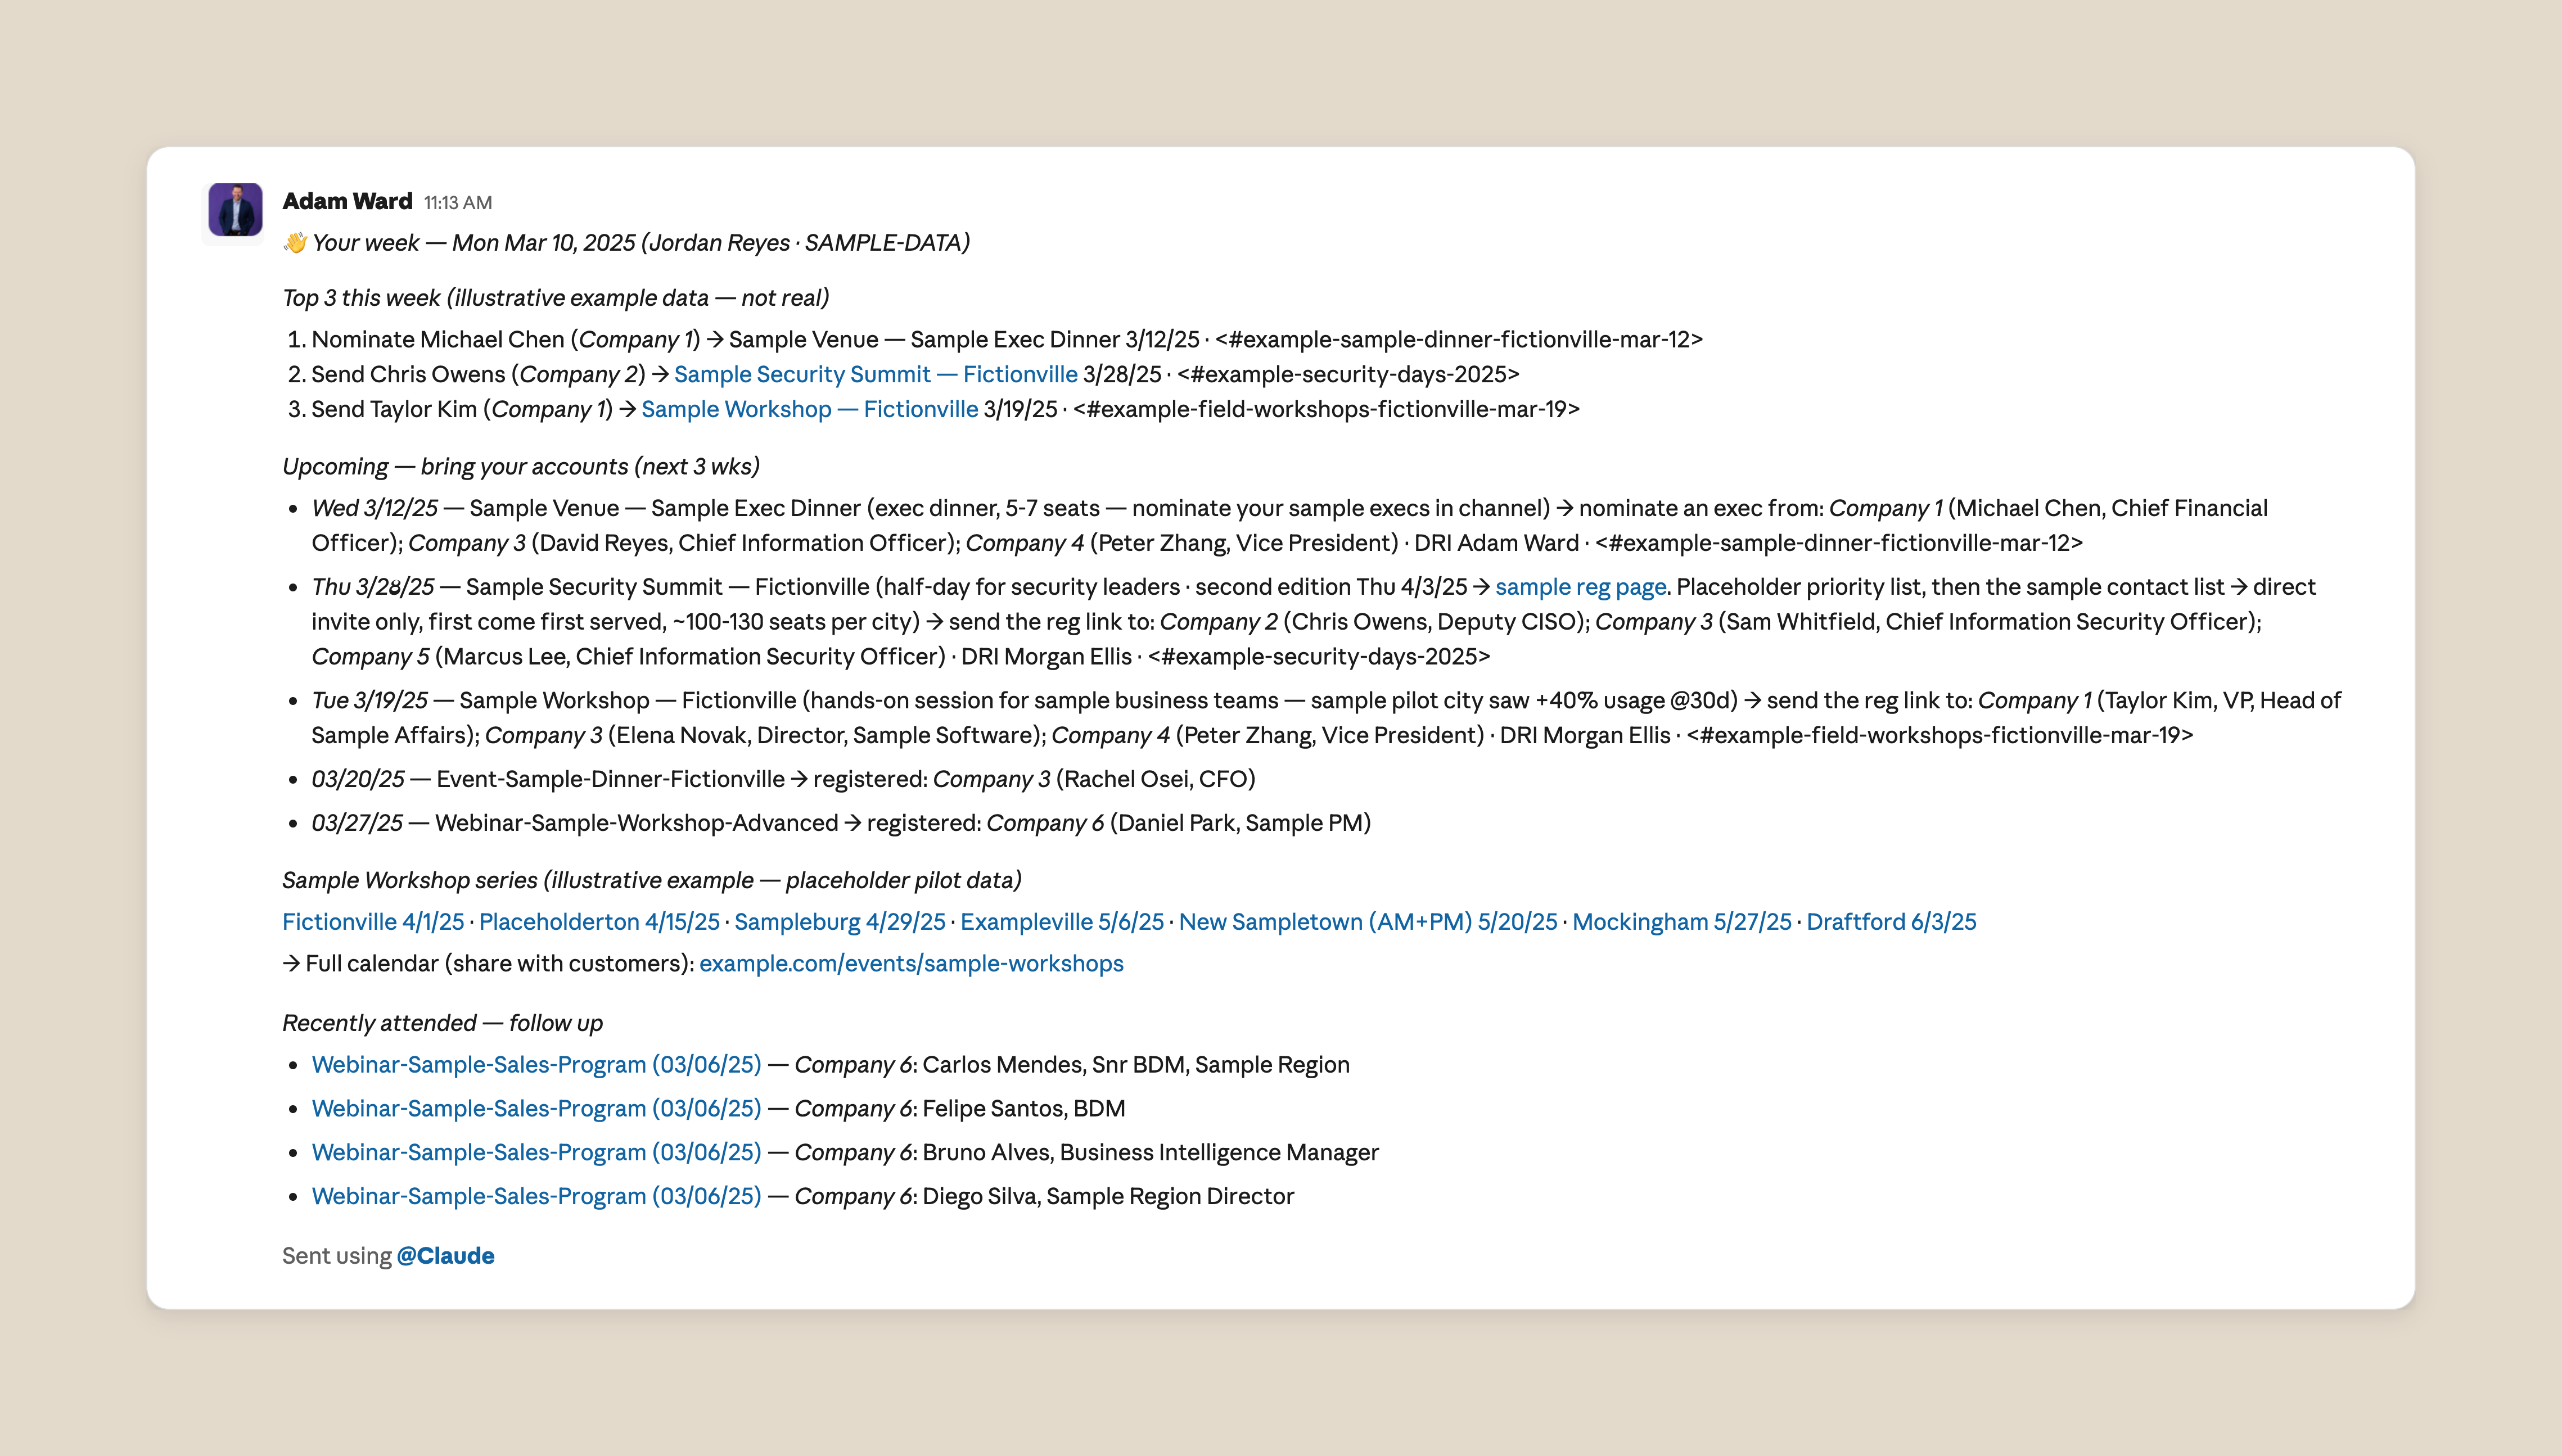
AI SummaryAnthropic营销人员Adam Ward分享如何使用Claude Code将每周销售报告自动化为每个销售代表的个性化周一简报,通过BigQuery MCP拉取数据,并根据反馈迭代prompt规则。
解读本质是Anthropic用自家Claude Code做内部dogfooding,展示非技术员工也能通过自然语言和反馈迭代构建自动化工作流。
AI SummaryOpenAI 宣布 GPT-5.6 现已集成到 Kiro 中,帮助开发者规划、构建、审查和测试软件,并强调更好的性价比。
解读模型能力竞争正转向开发者代理工作流,性价比成为关键卖点,实际效果仍需工作流验证。

AI SummaryTechCrunch 报道 OpenAI 推出 ChatGPT Work,将 Codex 能力扩展到非工程师,让 AI 代理处理邮件、日历等白领工作,但外部采用率低,面临可用性和竞争挑战。
解读OpenAI 把 agent 从程序员推向大众,但内部高采用与外部低采用的反差,说明产品化瓶颈在 harness 和权限设计,而非模型能力。
AI SummaryCloudflare 推出 WriteGuard(私有测试),为 MCP 服务器提供精细安全控制:拦截请求、按风险等级执行策略、归因与审计,无需修改 MCP 服务器本身。
解读把 AI 代理的写操作安全从各 MCP 服务器抽离到统一代理层,用风险分级和审计解决多工具权限失控问题。
AI SummaryNVIDIA 宣布 Vera Rubin NVL72 扩展:Groq 3 LPX 全面投产,Gemma 4 31B 上达 3400 tokens/s,并推出 Spectrum-X Multiplane 与 Scale。
解读本质是 NVIDIA 将推理瓶颈从训练算力转向 decode 延迟,用 GPU+LPU 协同的机柜级设计定义 agentic 时代基础设施,而非单一芯片突破。
Hugging Face · 技术报告 · 论文 · Benchmark · RL 研究
逐篇读取当天 paper 页面,由 deepseek-v4-flash-ga-260731 生成中文摘要。
AI Summary论文介绍 PrimeAgentOrchestrator(PAO)系统,为 Claude Code 编码代理预加载用户个人数据库中的记忆,通过双后端检索与文件系统注入,并报告四个月部署经验。
解读第三方基于 Claude Code 构建的记忆预加载系统,解决跨会话上下文丢失问题,属工程经验报告,非 Anthropic 官方发布。
X 大 V · YouTube / Podcast · Builder 观察 · 开发者讨论
AI SummaryReddit 用户发帖称,GitHub 项目 qwen38-27b-rtx3090 配合 DeepSeek harness 使用效果极好,但未提供具体评测数据。
解读本质是社区用户对本地推理项目的主观好评,无数据支撑,不能作为 DeepSeek harness 或相关模型能力的可靠证据。

AI SummaryMIT 技术评论文章探讨 LLM 与儿童学习语言的数据效率差距:模型需海量数据,儿童仅需少量输入即可掌握语言,研究这一差距或有助于构建更高效模型并理解语言习得机制。
解读核心不是模型发布,而是数据效率差距:儿童用百万词级输入掌握语言,模型却要万亿 token。这本身就是对当前 scaling 范式最有力的质疑。
解读本质是判断记录系统在 agent 时代从数据仓库变成执行层,不转型就会被绕过。观点先行,需看实际产品迁移和客户选择。